一个只能区分八种电学状态的存储单元,乍看很难成为高精度科学计算的基础。北京大学一个研究团队却用这类器件搭建系统,在实验中完成了 16 × 16 矩阵求逆,达到 24 位定点精度。这项成果于 2025 年 10 月 13 日发表,其精度来自一套能够自我校正的流程:把存在误差的计算组织起来,逐步修正结果。[1]
放在中国 AI 计算研究中看,这项进展的关注点落在器件与应用之间。加速器要用于实际计算,就得有办法表示数值、检查答案,并处理规模超出物理阵列容量的问题。这次实验将这些层次展示得格外清楚。
为粗略答案做精细核验
阻变式随机存取存储器(RRAM)以电导存储信息,电导描述的是电流通过器件的难易程度。存储阵列可以编码矩阵,借助电路的电学行为完成运算。这类技术的吸引力在于,信息可以在存储的位置直接处理;难点则是如何从物理元件中获得足够准确的答案。[2]
北大的方法将近似矩阵求逆与更高精度的矩阵–向量乘法配合使用。前一项运算给出修正量,后一项衡量修正后剩余的误差。反复执行这一过程,解的精度便逐步提高。乘法环节采用位切片(bit slicing),把一个数拆分成若干低精度部分,各部分的运算结果随后合并。校方公布的矩阵实验结果显示,迭代十次后,相对误差约为 10⁻⁷。[2]
理解这套硬件,需要区分单个存储单元的精度与整个计算结果的精度。系统付出额外计算,才获得后者;效率高低则取决于需要多少校正工作。
把迭代校正进一步移入存储器
用存在误差的器件计算时,迭代校正已有先例。2018 年,IBM 研究人员展示了一种混合精度设计,将大量计算交给计算型存储器,再由传统数字计算机提高答案精度。他们的实验包括使用近百万个相变存储器件,求解包含 5,000 个方程的方程组。[3]
这一先例明确了后续工程工作的着眼点:校正方法能够带来准确结果后,设计者便可以进一步安排各部分校正工作在哪里运行。北大这项研究将近似求逆和精确乘法都放到了模拟矩阵计算硬件上。[1] 运算位置的变化改变了系统架构,周边的控制电路和转换电路也随之成为评估性能的一部分。
用小阵列处理大问题
规模带来另一重挑战。存储阵列越大,制造限制、电路非理想特性,以及单元之间连线的电阻越需要考虑。直接放大一套已经验证有效的电路时,还需面对数值表现更难控制的风险。[4]
该团队此前的 BlockAMC 工作于 2024 年 1 月公开,并获同年 DATE 会议接收。它将大矩阵分成较小的块,分别对这些块求逆、相乘,再合并局部解。继续逐层分块,就能把较大的数学问题安排到较小的物理单元上处理。[4]
这一思路的实用之处,在于让算法适应能够制造出来的硬件。分块的代价是增加一系列运算,因此,评估单次计算的速度时,也要计入完成整个问题所需的计算次数。2025 年的精度实验已将分块处理纳入实际演示的求解器。[1]
把电路板与速度数据放在一起看
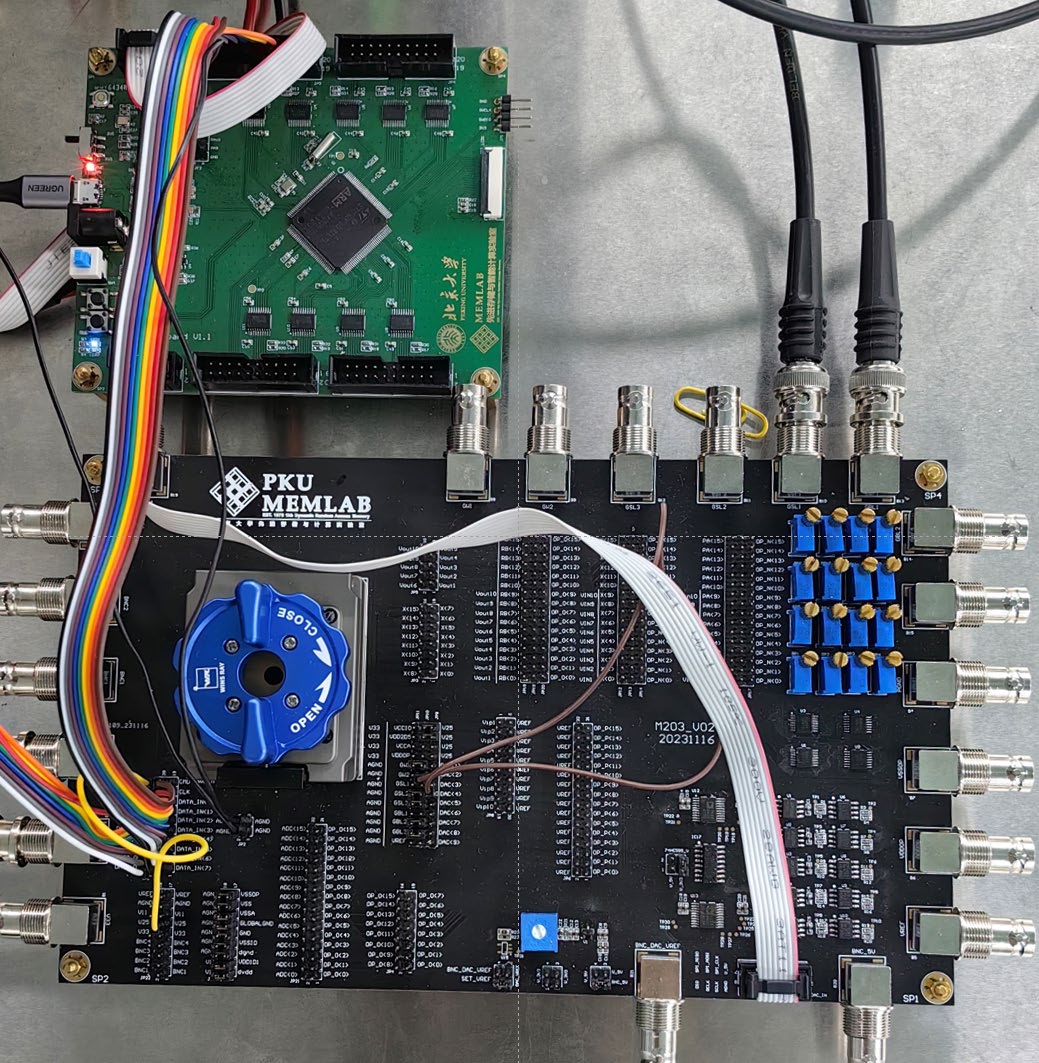
补充材料中的照片展示了一套仍由多个独立部件组成的系统。一台 PC 协调各块实验板;近似求逆使用 8 × 8 RRAM 阵列,精确乘法则使用一枚集成的 1-Mb RRAM 芯片。作者提出,未来将这些功能与数字控制整合进一颗片上系统芯片。[1]
实物系统与未来集成方案的区别,在性能比较中尤其重要。论文给出的最高性能增益——吞吐量最高约 1,000 倍、能效接近 100 倍——来自推算,其条件包括更大的阵列和更快的电路。GPU 吞吐量按单个核心归一化处理。据此认定求解器在 AI 应用中比完整 H100 快一千倍,超出了这些数据能够证明的范围。[1]
这项成果的价值落在两个更具体的层面:实验验证了一种获得精确答案的方法,性能模型则估算了进一步改进电路后的收益。分别看待这两项成果,后续研究便有了更清晰的依据。
下一项考验是集成
Piergiulio Mannocci 及其同事于 2026 年 1 月发表的一篇论文,展示了向集成迈出的又一步,北大的 Zhong Sun 也是作者之一。相较于前述 RRAM 研究,这项工作采用 SRAM(静态随机存取存储器)技术,将两个 64 × 64 阵列、反馈放大器和转换器集成在一枚 90 纳米芯片上。演示应用包括微分方程、轨迹跟踪和机械臂逆运动学。[5]
这是另一套独立设计,有各自的精度和工作负载适用范围。它与前述研究的联系在于技术发展的方向:为得到有用的答案,越来越多的配套电路正在移入芯片内部。在一个有说服力的计算平台中,存储阵列及其辅助功能都应当便于复现和管理。
北大这项研究还在公开资料库中提供了图表数据。[6] 读者可以据此检查论文图表背后的证据。接下来的问题集中在系统运行上:器件隔多久需要重新编程,哪些矩阵能够可靠收敛,以及从输入到得到符合要求的答案,整个系统耗费多少时间与能量?
这些问题把实验室成果与 AI 计算体系联系起来。研究者越能说明误差如何处理、消除误差需要付出多少代价,模拟计算的前景就越有依据。
资料来源
- Pushen Zuo 等,《Precise and scalable analogue matrix equation solving using resistive random-access memory chips》,Nature Electronics,2025 年 10 月 13 日;实验精度、架构及与 GPU 的预测性能比较。 补充材料,尤其是说明 3 和图 7;性能假设与原始硬件照片。
- 北京大学人工智能研究院,Zhong Sun 团队 Nature Electronics 研究成果公告,2025 年 10 月 15 日;关于迭代精化、位切片及精度实验的中文一手资料。
- Manuel Le Gallo 等,《Mixed-precision in-memory computing》,Nature Electronics,2018 年 4 月 17 日;IBM Research 的论文记录,介绍混合校正架构及实验演示。
- Lunshuai Pan 等,《BlockAMC: Scalable In-Memory Analog Matrix Computing for Solving Linear Systems》,2024 年 1 月 18 日;获 DATE 2024 接收的作者稿,说明矩阵分块与阵列限制。
- Piergiulio Mannocci 等,《A fully integrated analogue closed-loop in-memory computing accelerator based on static random-access memory》,Nature Electronics,2026 年 1 月 14 日;SRAM 集成方案及演示应用。
- Pushen Zuo,《Precise and scalable analog solving of matrix equation》,Zenodo,第 2 版,2025 年 5 月 12 日;北大研究图 2–5 所用数据的公开电子表格。