想象一下,刚导入的图库打开了,所有缩略图都在,其中那张家庭合影的说明文字,是打了三通电话才补全的。接着按照片里的人名搜索,结果却是空的。迁入开源照片管理软件 digiKam,验收标准应当更严格一些:附着在照片上的知识,也要随照片一起迁移。可以先选一小组照片,让它们经历一次导入 digiKam、再从中导出的往返。[1]
项目的迁移文档介绍了一种实用的衔接办法:让原来的应用把元数据写入 XMP 附属文件(sidecar),由这些与照片相伴的文件携带相关信息。digiKam 可以读取它们,将信息存入自己的数据库;对于直接解析专有格式的编目库,digiKam 没有作出承诺。[1] 下文的演练是在这一办法基础上提出的工程建议。设置名称沿用在线手册,查阅时手册标注的版本为 9.2.0;使用时请与已安装的版本核对。
搬动照片之前,先把信息打包
先将旧编目库、原始文件和已有的附属文件一并备份,并将备份与工作副本分开保存。让原来的应用导出日常依赖的描述性字段,再在两个程序之外记下几项预期结果:完整准确的说明文字、标签层级、评分和位置。仅凭对旧图库的印象,很难做好逐项比较。
演练时,建议选取 30–50 份影像副本,有意纳入一些棘手的情况:主文件名相同的一对 RAW 与 JPEG 文件、人脸区域附有人名标注的肖像照、含重音字符的说明文字、多层嵌套的关键词,以及一段视频(如果图库中也有视频)。这个数量只是建议的样本规模,不代表 digiKam 的上限。还应选入一张最近修正过元数据的照片;知道新值是什么,旧信息就更容易辨认。
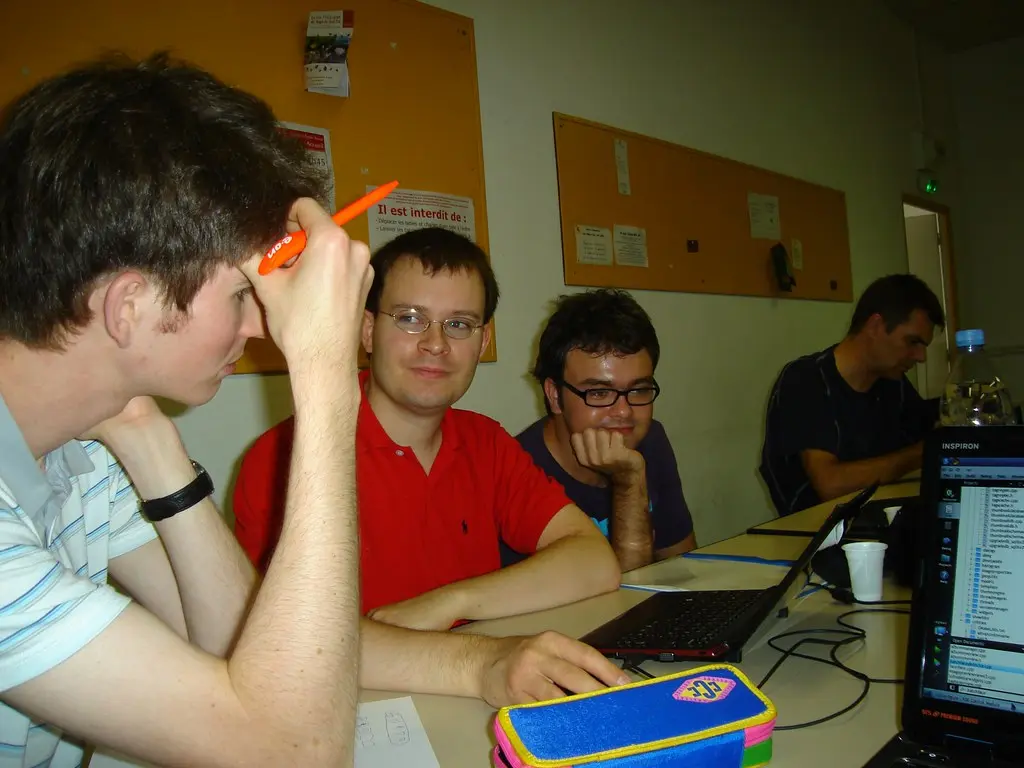
照片本身与照片的组织方式,长期以来就是两件事。2010 年 8 月,项目贡献者在普罗旺斯地区艾克斯的集中开发活动中讨论过 Nikon 照片集合的迁移:导出的照片可以携带关键词树,虚拟文件夹的重建则是另一个问题。参与者的记录也提到了附属文件和人脸元数据方面的工作。[7] 本文所配的历史照片便来自那次活动。今天的演练仍在追问同一件实用的事:旧图库中的哪些内容,确实已经导出了?
确定哪一份说明文字优先
在 Settings → Configure digiKam → Metadata(设置 → 配置 digiKam → 元数据)中,Behavior(行为)选项卡用于选择要写入的字段,Sidecars(附属文件)选项卡则分别控制读取和写入。选择仅写入 XMP 时,图像文件内部的元数据保持原样。手册给出的默认命名方式是 image1.dng.xmp;启用商业软件兼容选项后,文件名则为 image1.xmp。[2]
手册还说明,启用附属文件读取后,digiKam 会忽略图像内嵌的元数据,优先采用附属文件中的内容。高级设置可以排列读取说明文字等字段时所查找的命名空间,最先找到的有效值会被采用。启用延迟同步(Lazy synchronization)后,写入可推迟到提交待处理更改或关闭程序时。[2]
演练中应明确记录这些选择。用一段过时的内嵌说明文字与附属文件中修正后的内容作比较,再检查那对 RAW/JPEG 文件的命名是否存在歧义。每次更改设置前,先记下结果,试验成功后再保存所用设置。正确的说明文字为什么会出现,应当有一套能够重复验证的解释。
验证信息能否随文件带出
导入样本后,将预先记录的值与 digiKam 的条目属性逐一比较。然后,在这组副本中修改一段说明文字、一个评分和一个嵌套标签。接下来要到编目库之外,检查接收这些更改的文件。
ExifTool 可以从独立于 digiKam 的角度读取元数据。下面两条只读命令分别显示 JPEG 文件及其附属文件中的 XMP 元数据;请将文件名替换为当前配置实际生成的名称:[5]
exiftool -G1 -a -s -XMP:All pilot/IMG_0042.jpg
exiftool -G1 -a -s -XMP:All pilot/IMG_0042.jpg.xmp
-G1 标明元数据所属的组,-a 包含重复标签,-s 显示标签名称。两个文件都读一遍,就能看到相互冲突的值。[5] 如果工作流程有意只写入附属文件,那么内嵌说明文字保持原样属于预期行为;接收照片的应用仍须知道该采用哪一个值。
将测试输出的文件复制到另一个测试环境中,用全新的编目库导入;也可以在之后将接收这些照片的应用里打开它们。再比较一次各项值。这一步能查出一种表面成功的迁移:digiKam 显示的信息正确,因为数据库还记着这些信息,另一个读取程序却无法从交付的文件中恢复它们。
Anna Simon 在 Linux Magazine 发表的独立实操教程,从摄影者实际使用元数据的需要出发介绍 digiKam,尤其关注位置信息,以及如何再次找到照片。[6] 这里也应采用这样的衡量标准。说明文字以 XML 形式保留下来,已有用处;到了下一个工具中,它仍能作为信息被搜索到,这项测试才算完成。
同步有明确的方向
digiKam 的元数据同步器(Metadata Synchronizer)有两个方向:从文件同步到数据库,或从数据库同步到文件。具体行为取决于元数据设置;对于大规模任务,手册建议将范围限定在选定的相册或标签内。[3]
初次导入时,需要保留的信息来自原应用导出的文件。在 digiKam 中作出明确修改后,准备向外写入的新值则保存在它的数据库中。这两种操作应分开处理。如果面对旧数据时选错同步方向,刚刚修正、希望用演练保护的内容就有被覆盖的风险。先在样本上演练两个方向的操作,检查输出,再扩大范围。
确定编目库放在哪里、由谁管理
对于单个摄影者,或指定一人负责编目的小型档案库,本地 SQLite 数据库是一个简便的起点。digiKam 默认使用 SQLite;手册要求这些数据库文件保存在本地文件系统中,不能放在网络共享目录上。手册也将 digiKam 数据库后端之间的迁移,与导入其他应用的编目库分开说明。[4]
使用共享服务器会增加协调工作。文档所述的共享数据库方案要求各处的 digiKam 版本一致,并且禁止多个实例同时访问。即使各自使用独立数据库读取同一组共享照片,写入文件元数据时仍须谨慎。[4] 如果团队需要多人同时编辑编目库,应在采用这套工作流程之前先解决这一要求。
旧编目库应保留到这样的时刻:将交付文件重新导入一个全新的编目库后,所关心的字段都能重现。除了图像和附属文件,也要备份 digiKam 的数据库;其中还保存着照片文件之外的照片集合与搜索状态信息。[1][4] 随后将图库的其余部分分批迁移,每一批都以有人能够核查结果为宜。值得庆祝的时刻,是再次找到那位曾经仔细辨认的家人,照片说明完整无缺,并且在最后编辑它的应用之外也能恢复。
来源
- digiKam 手册,“Database”——内部存储,以及借助 XMP 附属文件从其他软件迁移。
- digiKam 手册,“Metadata Settings”——字段选择、附属文件命名、读取优先级、命名空间与延迟写入。
- digiKam 手册,“Metadata Synchronizer”——同步方向、范围及其与元数据设置的关系。
- digiKam 手册,“Database Settings”——SQLite 本地存储、共享访问限制、后端迁移与备份。
- Phil Harvey,“ExifTool Application Documentation”——元数据提取、组名、重复标签与简短标签名。
- Anna Simon,“Metadata Wizard”,Linux Magazine,第 290 期,2025 年 1 月——关于照片元数据和地理标签的独立实操教程。
- Martin Klapetek,“KDE Imaging Coding Sprint 2010”,digiKam,2010 年 9 月 6 日——普罗旺斯地区艾克斯活动的参与者记录与历史照片。