2024 年 10 月,上海天文台宣布,由 Jian Ge 领衔的国际团队从此前已发布的开普勒观测数据中找到了五颗比地球更小的行星。它们各自绕恒星一周的时间都少于一天。团队带来的新方法名为 GPFC,将图形处理器计算与神经网络结合,用于搜索行星信号。[1]
这个中国 AI 研究案例有一种具体可感的吸引力:望远镜测量星光,多年以后,研究者换一种方式审视这些测量记录,又发现了一个世界。接下来的问题是,这次重新审视,要怎样才能成为可信的发现。
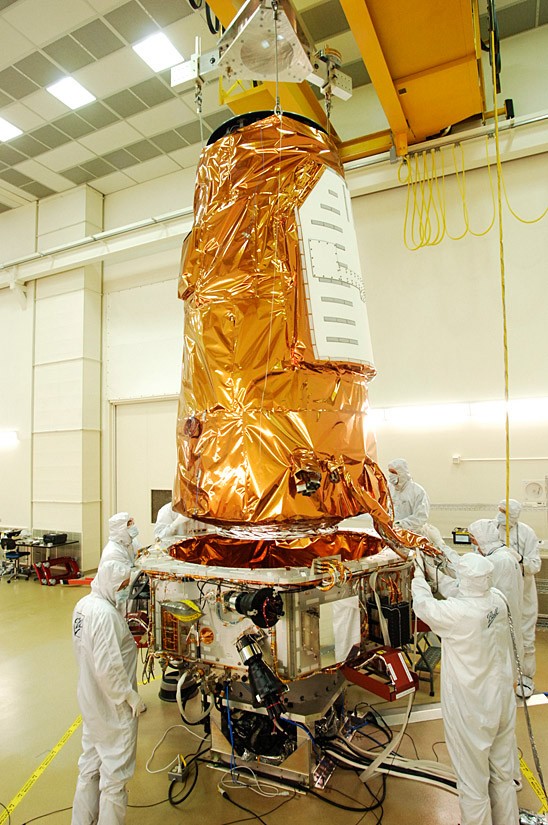
上方的历史照片把故事带回仪器装配之初:洁净室里,开普勒光度计正被吊放至航天器上。[5] 后来的软件有赖于这台早先造好的仪器,也有赖于人们保存它留下的记录。
目录之外,任务还留下了观测档案
开普勒的主要观测阶段从 2009 年 5 月持续至 2013 年 5 月。空间望远镜科学研究所保存的任务档案包含几类不同的数据产品:记录亮度随时间变化的光变曲线、各个观测目标周围的像素图像,以及覆盖更大视场的图像。MAST 服务支持逐项检索、程序化访问和批量下载。[4]
目录与档案的区别由此变得清楚。目录记下的是截至当时已有的结论,保存下来的测量记录则让其他研究者有机会提出不同的问题。像素数据与亮度记录一同留存,也给可疑信号留下了核查的依据:望远镜视野中,当时还有什么?
这项发现研究使用了开普勒第 25 次数据发布(Data Release 25)的数据,并从已有的开普勒感兴趣天体目录(Kepler Objects of Interest)中选取目标。搜索覆盖的轨道周期为 0.2 至 1 天,研究者先移除已识别的凌星信号,再寻找额外信号。[3] 这项研究有意限定范围,专门考察轨道周期极短的行星。
让微弱的周期信号逐次叠加
行星从恒星前方经过时,会让望远镜接收到的星光短暂减弱,这种现象称为凌星。GPFC 用相位折叠寻找反复出现的亮度下降:先假定一个轨道周期,把各次观测放到周期内的对应位置,再将记录叠加。周期选得准确,连续多次的亮度下降便会相互增强;周期有偏差,微弱信号就容易被抹平。[2]
可以想象,在人群交谈声中辨认一种轻轻的敲击声。如果知道敲击何时再次响起,就能把多次重复中的线索累积起来。但在望远镜数据中,这个节奏起初尚未确定,搜索必须尝试许多不同的周期。
2024 年 1 月发表的方法论文介绍,研究者用一块 Nvidia GeForce RTX 3090 Ti,按 100,000 个试探周期对每条光变曲线做相位折叠,再由卷积神经网络为折叠后的记录打分,识别其中类似凌星的形态。[2] 两个部分各司其职:GPU 让密集的周期搜索成为现实,训练好的网络则评估每次对齐后显现的信号。
沿着这份分工,更容易看清成果的由来。笼统地说 AI 更擅长天文学,仍不足以解释这项工作;它的实用创新,在于让更多信号进入细致的计算检验。
让搜索方法认识罕见信号的模样
真实样本的数量给训练带来了困难。上海天文台的介绍指出,已知凌星信号太少,难以满足团队的训练需求。研究者因此依据凌星物理生成合成样本,结合真实的开普勒光变数据,制作了包含 200 万条曲线的训练集。[1]
合成训练数据与观测证据承担着不同的任务。对于自然界只留下少量实例的信号形态,合成数据可以补充训练样本。至于某一颗行星是否存在,仍须回到实际测量记录中寻找证据。
这种区分也指出了方法的局限。如果训练样本的生成方式只涵盖一小类信号,那么即便搜索成功找出了这一类信号,对其他类型的识别能力仍有待研究。由此来看,生成样本所依据的物理,与网络架构同样值得关注:搜索能够留意到什么,部分取决于这些物理设定。
高分信号,还要经受下一轮检验
发现论文列出了十项审核测试,包括检查邻近恒星、寻找提示食双星存在的次食,以及核查检出的周期是否与某个已知信号的相关重复周期混淆。此外,采用 GPU 实现的箱形拟合最小二乘法(Box-fitting Least Squares)也在相同周期上重新检出了全部五个候选信号。[3]
最后一项核查尤其能说明问题。采用验证环节所用的搜索精度时,传统方法同样能找到这些信号。成果既来自网络对形态的识别,也来自对观测数据更细密、更充分的搜索。
论文报告的成果之一 Kepler-879c,估算半径约为地球的 0.4 倍,轨道周期约为 15.5 小时。[3] 这些测量值呈现了此次发现不同寻常的尺度;它们描述的是当时的研究成果,至于今天已知最小行星的纪录,则是另一个问题。
对中国的科学 AI 研究而言,这个案例揭示了共享档案中的实际机会。团队可以将新的搜索方法用于其他地方采集的观测数据,同时保留一路追溯至仪器与数据的证据链。MAST 持续开放测量记录和配套文档,让这样的重新探访有了条件。[4]
接下来值得追问的是,一次搜索究竟覆盖了多大范围。更宽的周期区间、不同的恒星,以及更陌生的信号,各自会检验这套方法的不同部分。GPFC 报告的五颗行星发现,为重新审视旧数据给出了有力理由。余下的档案仍在邀请研究者继续追问:这套搜索方法准备好识别哪些信号?
来源
- 上海天文台,《利用人工智能发现靠近类太阳恒星的极小行星》,2024 年 10 月 14 日;机构发布的中文报道,介绍团队、训练数据与发现。
- Kaitlyn Wang 等,《用于探测系外行星凌星的 GPU 相位折叠与深度学习方法》,MNRAS,2024 年;作者稿第 2 版,2024 年 1 月 21 日,重点参见第 2.3–2.7 节。
- Kaitlyn Wang 等,《利用 GPU 相位折叠与深度学习发现绕开普勒 K、G 型矮星运行的小型超短周期行星》,MNRAS,2024 年;作者稿第 3 版,2024 年 9 月 14 日,重点参见数据集选择与候选信号验证部分。
- 空间望远镜科学研究所,MAST 开普勒任务档案;观测日期、保存的数据产品、文档与访问工具,访问日期:2026 年 10 月 13 日。
- NASA Science,《开普勒光度计吊放至航天器上》;洁净室历史照片,署名 Ball Aerospace,页面日期:2009 年 12 月 18 日。