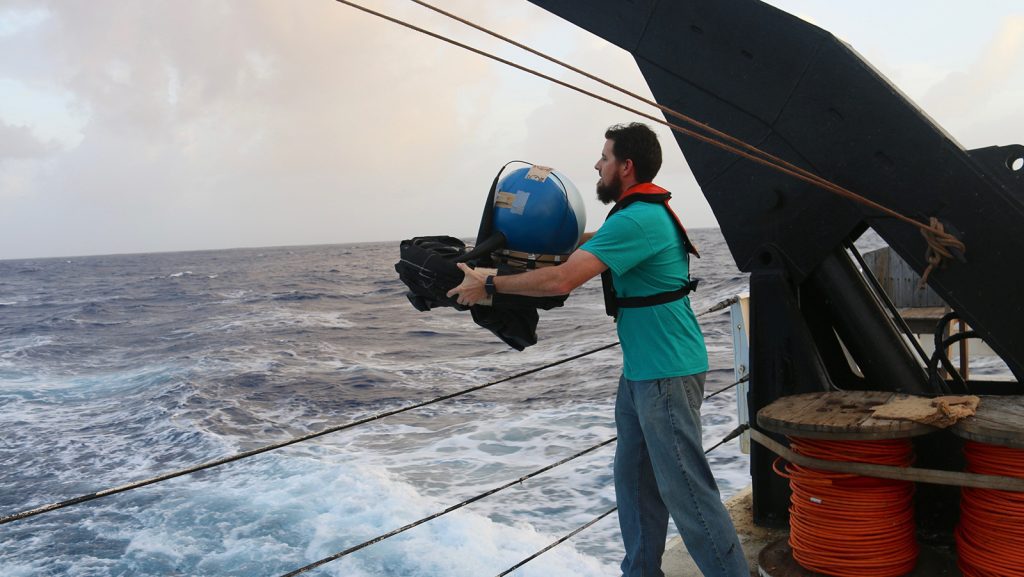
一枚漂流浮标,让一片海水有了可测量的记录。传感器记录水温,连续的位置记录则显示洋流将它带向何处。水面下,系在浮标上的浮锚帮助仪器随水流移动。美国国家海洋和大气管理局(NOAA)的全球漂流浮标计划详细说明了这种装置配置,因为数据的含义取决于它:一旦浮锚脱落,风浪对浮标的影响就会改变。[1]
从这里看中国的海洋 AI 研究,能找到一个出人意料却有用的起点。预报以一组数值呈现,评判这些数值时,研究者又得回到仪器、采样和观测资料的整理工作。
OceanForecastBench 将这条回到观测的路,变成了研究者共用的工具。2026 年 7 月 28 日,主要来自中国国防科技大学的 Yi Han 及其同事发表了这项工作,将训练数据和基于观测的评估加以标准化。[2] 将它与此前的一次模型发布、一场国内研究论坛放在一起看,可以看到这个领域正在投入精力,改善相互比较研究成果的条件。
本文梳理了 2024 年至 2026 年的这些记录,公开资料核查截至 2026 年 10 月 11 日。
从模型发布到共同面对的问题
XiHe 的公开代码仓库记载,其预训练海洋预报模型于 2024 年 2 月 8 日发布。项目可生成未来 1 至 10 天的预报,以 ONNX 格式分发模型,并附有完整的推理示例。使用说明还详述了初始海洋场的准备方法,包括使用其他输入数据时所需的深度对应关系。[3]
这些细节说明了模型获取之后的工作。权重开放下载,其他研究者便能尝试运行模型;预报仍取决于如何表示初始海洋状态。两支团队即使采用相同架构,准备方式的差异也足以让它们在进入预测步骤之前,就做成两种不同的实验。
到 2025 年 7 月 12 日,中国计算机学会在中国海洋大学举办的论坛已明确讨论海洋模型共同面对的数据问题。论坛的中文报道指出,观测资料稀疏、噪声较多,通用系统也难以适应具体应用。发言者介绍了多种研究方向,包括基于物理和机器学习的预报方法,以及 OceanGPT 基于语言的工具。[4]
这场论坛尚不足以确立统一的技术共识,也未表明其与 OceanForecastBench 存在直接的组织联系。不过,合看这些记录,可以辨认出关注重点的转移:从研究者能否获得模型,逐渐转向能否为模型准备一套可相互比较的实验。
训练文件中的海洋
核心数据之一是哥白尼海洋服务(Copernicus Marine)发布的海洋再分析产品 GLORYS12。再分析将数值模型与观测结合,重建过去的海洋状态。GLORYS12 使用 NEMO 海洋模型,同化卫星海平面、海表温度、海冰,以及水下温度和盐度剖面等观测。其原生网格的水平分辨率为 1/12 度,垂直方向有 50 层。[5]
这份海洋记录经过了精心制作。若将它看作直接摄下的现实影像,就会忽略模型计算和数据同化的工作,而连续的全球记录正是由这些工作得来。对 AI 模型而言,这份记录具备一致性;对评估者而言,它也说明了另行核对实测数据的理由。
OceanForecastBench 已发布的训练数据采用 1.40625 度网格和 23 个深度层。[7] 论文所述方案使用 1993–2017 年的数据训练,使用 2018–2020 年的数据验证;评估时,以 2022–2023 年 Mercator 业务化分析场作为预报初始场,考察未来 1 至 10 天的预报。实验使用了 8 块 NVIDIA RTX 4090 GPU。[2]
较粗的网格决定了这套方案适合作为怎样的研究起点。在这里取得成功的实验,可以成为进一步开展精细分辨率测试的依据;至于模型能否描述港口入口附近的水流,仍需另行验证。空间尺度本身就是理解结果的一部分。
观测数据也有来历
公开仓库具体列出了评测所需的观测资料。约定的测试目录分别存放温盐剖面、漂流浮标流速和海表温度数据,以及卫星海平面记录。示例文件名中标有 EN4 剖面和一套 6 小时间隔的漂流浮标数据集。[7] 这些目录让待测模型究竟要与什么比较变得清楚。
英国气象局的 EN4 文档区分了两种产品:一种是带有质量信息的水下温度和盐度实测剖面,另一种是由这些剖面生成、附带不确定性估计的客观分析资料。[6] 两者对应不同需求。选择剖面,比较便保留在实际采样的位置和深度上;选择分析资料,则引入了另一层重建过程。评估者需要清楚,究竟是哪一种文件进入了计算。
漂流浮标记录同样经过整理。NOAA 在 2023 年 9 月发布的 ERDDAP 服务公告中介绍,用户可获取每小时和每 6 小时一条记录的、经过质量控制与插值处理的数据集,既可选择常见文件格式,也可通过程序请求读取。[8] 一次实测在成为易于下载的数据之前,已经历了一系列处理。
这对中国 AI 研究的启示很具体:可复用的评测既依靠国内建模工作,也依靠国际观测服务。仔细衔接这些资源,本身就能成为有价值的贡献。即使软件界面让这项工作显得寻常,衔接过程仍属于科学研究。
正式论文与代码仓库的测试清单有所不同
期刊最终发表的论文评估了五个基准模型:PSY4、ResNet、SwinTransformer、ClimaX 和 FourCastNet。公开 README 还列出了 XiHe。因此,解读已报告的实验应以论文为准,README 则展示了范围更广的模型清单。单独依据其中任何一份清单,都不足以给相关文献中提及的所有海洋模型排出统一名次。[2][7]
这处细小差异说明,共用的基准测试也需要按版本留存记录。读者应当能够将一个结果对应到论文版本、模型配置、观测文件和评估代码。一个熟悉的基准名称,本身容纳不了这些全部信息。
下一步更有说服力的进展,应当来自独立团队使用这套共同方案、记录改动,并展示改进在哪些变量、深度和预报时效上仍然成立。若要声称模型适用于局部海域导航,就需要相应海域和尺度的测试。若要声称运行成本更低,则需要同时计入准备输入数据和生成预测的成本。
OceanForecastBench 的贡献,在于让比较过程中的更多环节可供核查。更广泛的机会来自研究成果的逐步积累:一组研究者改进模型,另一组便能按一套明确的实验方案检验改进。进展留下的成果,也就能比醒目的分数更长久——其他研究者可以用同一批观测,对结果提出质疑。
资料来源
- NOAA 大西洋海洋与气象实验室,《全球漂流浮标计划》;介绍仪器组成、浮锚和观测方法,访问于 2026 年 10 月 11 日。
- Yi Han 等,《OceanForecastBench:面向数据驱动全球海洋预报的基准数据集》,Journal of Geophysical Research: Machine Learning and Computation,2026 年 7 月 28 日;最终发表版本中的方法与基准模型清单。
- Ocean-Intelligent-Forecasting,“XiHe-GlobalOceanForecasting”;官方发布历史、模型下载与推理说明,访问于 2026 年 10 月 11 日。
- 中国计算机学会 YOCSEF 青岛,关于 2025 年 7 月 12 日海洋大模型论坛的报道,发表于 2025 年 7 月 19 日(中文);参与研究团队及数据难题的一手记录。
- 哥白尼海洋服务,《全球海洋物理再分析》,产品编号 GLOBALMULTIYEARPHY001030;介绍 GLORYS12 的分辨率、模型与同化观测,访问于 2026 年 10 月 11 日。
- 英国气象局哈德莱中心,《EN4:经过质量控制的水下海洋温盐剖面与客观分析》;说明剖面与分析资料的区别,访问于 2026 年 10 月 11 日。
- Ocean-Intelligent-Forecasting,“OceanForecastBench”;公开 README、测试数据目录与基准模型清单,访问于 2026 年 10 月 11 日。
- NOAA/AOML 传播部门,《ERDDAP 服务器拓宽漂流浮标数据获取渠道》,2023 年 9 月 18 日;介绍数据处理与获取方式,也是 Shaun Dolk 投放漂流浮标照片的来源。