原子靠近某个处理器负责的区域边缘时,仍会受到另一侧近邻的作用。这个小小的麻烦,解释了 LAMMPS 架构中的许多安排。这款开源分子动力学程序把模拟空间分给各个进程,再向每个进程分发附近原子的副本,称为幽灵原子(ghost atoms)。进程之间交换信息,让整个系统随时间向前演化。沿着这些副本的流转看下去,既能理解计算为何可以扩大规模,也能看清继续增加处理器为何终会带来高昂开销。[1][2][3]
LAMMPS 模拟相互作用的粒子,既包括固体中的原子,也包括对材料的粗粒化表示。它能在笔记本电脑上运行,也能使用并行计算机。本文依据项目 2026 年 9 月 2 日发布版本的文档,聚焦空间分解和常规的 velocity-Verlet 时间步。有些加速器软件包和特定模型会改变其中的细节。[1][5]
一块辖区,以及借来的近邻
LAMMPS 使用 MPI(消息传递接口)开展分布式计算,每个 MPI 进程分得一个空间子域。默认的 comm_style brick 将这些子域排成规则网格。粒子分布较为均匀时,这种划分效果良好;若是一滴稠密液滴被大片空旷区域包围,有些进程的工作量就会远超其他进程。processors、balance 命令以及 tiled 分解方式,可以用来调整这种布局。[2]
分配给某个进程的粒子,是该进程的所属原子(owned atoms)。计算子域边缘的短程相互作用时,进程还要取得其他进程所属原子的部分数据。幽灵原子就是这类副本,其范围由通信截断距离限定。它们也表示周期性边界另一侧的近邻:在这种边界条件下,模拟盒相对的两个面被视为彼此连通。[3]
这种按需复制让进程只存储自己负责的区域和近邻信息,就能完成局部计算。副本也要持续更新,才能参与后续计算。在 LAMMPS 的术语中,正向通信(forward communication)把坐标等信息从所属进程发往持有幽灵原子的进程;反向通信(reverse communication)则把算出的力等贡献送回所属进程,在那里累加。两者分别负责分发输入和汇集结果。[3]
记住该检查哪些近邻
确定哪些粒子彼此相近,本身就需要计算。LAMMPS 保存邻居列表,让力计算只检查候选粒子对。列表的范围在力的截断距离之外,还加上一段称为 skin 的缓冲距离。划分空间格子有助于高效建立这些列表,建好后便可在后续时间步中复用。[4]
假设力的截断距离为 10 个距离单位,skin 为 2,候选列表就延伸到 12。距离在 10 到 12 之间的粒子被列入候选,是为了后续有机会进入相互作用范围;物理上的力截断距离仍保持原值。这段余量让列表能够沿用更久。开发者指南描述了一种典型的重建触发条件:只要任一原子自上次建表以来移动了 skin 距离的一半,就触发重建。[4]
预留余量也有代价。skin 越大,需要检查的候选粒子就越多,有时还会增加通信量;skin 较小,也会遇到必须更频繁重建列表的情况。邻居列表还会占用大量内存,项目文档指出,它通常是程序中最大的数据结构。因此,调节 skin 要在反复搜索的开销与额外的存储、检查开销之间权衡。最快的设置取决于具体问题。[4][6]
一个时间步中的两条路线
在 Verlet::run() 中,积分过程更新位置后,neighbor->decide() 判断是否重建邻居列表。沿用列表的时间步则调用 comm->forward_comm(),刷新幽灵原子的坐标。[5]
需要重建时,程序先按周期性边界重新映射坐标,将原子迁移到新的所属进程,再用 comm->borders() 建立幽灵原子,并调用 neighbor->build()。原子归属随列表重建一起调整,因此原子越过子域分界线后,可以等到重建时再转移归属。[5]
力计算结束后,若启用了牛顿定律相关处理,反向通信会把幽灵原子的力贡献送回所属进程。随后,积分过程完成速度更新。邻居列表可以复用,原子坐标仍须更新:候选粒子保持在列表中,坐标则继续变化。[5]
对扩展 LAMMPS 功能的开发者而言,这套次序与力的公式同样重要。新加的操作要在恰当阶段取得所需数据,并赶在所属进程使用结果之前,把计算贡献送回去。
分配更多计算资源,为何有时收效有限
看基准测试之前,可以先看几何关系。一个近似立方体的子域,边长记为 L,体积按 L³ 增长,表面积则按 6L² 增长。若通信所需的外围层较薄且厚度固定,子域越小,这一外围层相对于子域体积的比例就越大。这段推导解释的是几何关系,加速效果仍要以测量为据:同一个模拟盒划得越细,每次通信所对应的本地计算就越少。[2][3]
性能指南指出了与之对应的实际限制:每个 MPI 进程分到的工作单元过少时,通信有时会占据主要开销。指南还提醒,长程静电计算会带来额外成本。粒子—网格求解器 PPPM 使用并行三维傅里叶变换,其并行扩展特性与前文所述的近邻粒子通信不同。[6]
因此,有用的实验可以很朴素:保持物理问题不变,选取一个已达到平衡的代表性构型,分别用几种进程数运行,再查看各项耗时。通信时间上升有时反映的是负载不均和进程等待,因此还要检查原子数在各进程间的分布。缩短完成时间与高效利用所分配的资源彼此相关,衡量时仍要分别观察。[6]
局部计算背后的共同投入
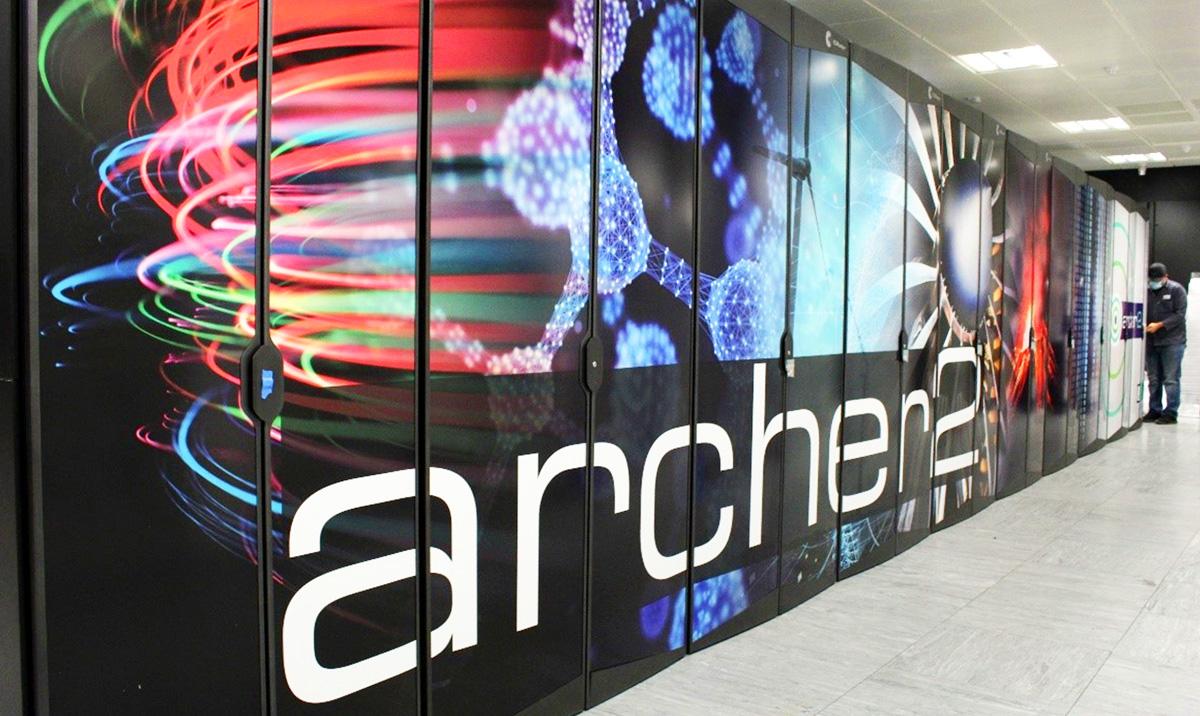
ARCHER2 运营方的文档给出了一个具体部署实例:LAMMPS 已作为科研软件安装,并附有并行作业指南。[7] 研究人员获得这套计算设施的使用权限后,就能调用已有的通信与积分程序。
一篇较早的独立报道,让这种共同投入有了具体的人和事。The Next Platform 报道 2015 年 GPU 技术大会的一场演讲时,转述了宝洁(P&G)科学家 Russell Devane 的解释:LAMMPS 和 NAMD 的 GPU 改造工作,超出了他所在的小型计算化学团队自身的能力范围。团队受益于这些软件包中已经完成的工作。[8]
在笔者看来,这套架构的长久价值在于:研究团队可以改变自己的模型,同时共用一套负责分配计算任务的工程成果。这仍然需要懂得模型、能够检查并行扩展测试的人。幽灵原子把近邻数据送到需要它的地方;所选的相互作用模型能否准确描述材料,仍要由研究人员判断。
来源
- LAMMPS,《LAMMPS 概览》,2026 年 9 月 2 日发布版本的文档——粒子模型、MPI、加速与可扩展性。
- LAMMPS,《分区》——空间子域、brick 与 tiled 布局,以及负载均衡。
- LAMMPS,《通信》——幽灵原子、周期性边界,以及正向与反向通信。
- LAMMPS,《邻居列表》——力截断距离加 skin、列表重建、空间格子与内存使用。
- LAMMPS,《一个时间步如何运行》——Verlet 积分循环、原子迁移、通信与力计算。
- LAMMPS,《性能测量》——邻居列表的取舍、并行效率、PPPM 与耗时分析。
- ARCHER2 用户文档,《LAMMPS》——计算服务提供的已安装软件说明与并行作业指南。
- Nicole Hemsoth Prickett,《宝洁向 GPU 计算迈进一步》,The Next Platform,2015 年 3 月 18 日——关于小型研究团队使用现有分子动力学软件的独立报道。
- EPCC,《ARCHER2》——系统官方页面,也是标为“ARCHER2 full system 2021”的照片来源。