一个小小的圆点,就能改变音符的时值。软件读取扫描乐谱时,找到这个点只是起步,还要判断它属于哪个符号。开源光学乐谱识别应用 Audiveris 用一连串图像处理步骤和一张音乐解读关系图来处理这个问题。顺着这套设计,可以看清纸面乐谱如何成为可编辑的音乐,也能理解一次人工校正为何会影响远超被修改符号的范围。[1][2][5]
Audiveris 将识别功能与交互式编辑器结合起来,并可导出 MusicXML,供打谱软件使用。文档明确限定了它的处理范围:采用西方通用音乐记谱法的印刷乐谱,手写乐谱在此范围之外。本文以 5.11 版手册为依据,涉及实现细节时参照 5.11.0 版源代码。[1][8]
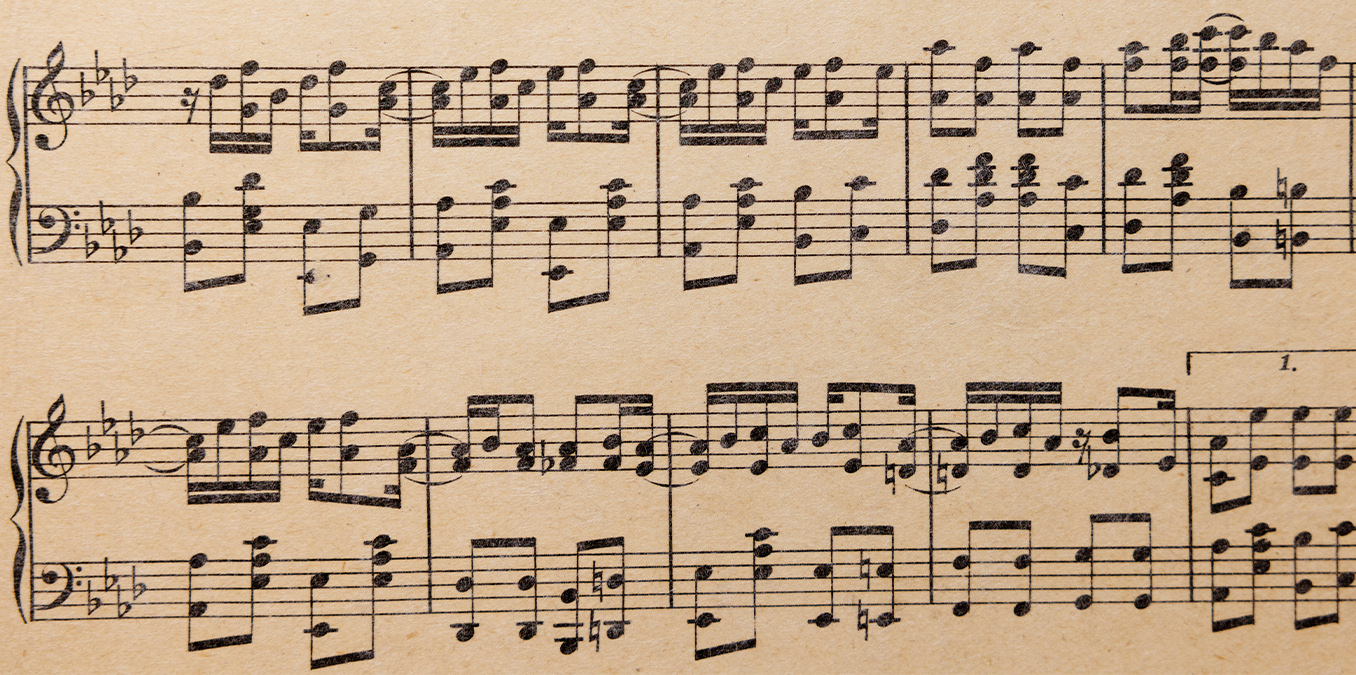
先读页面,再读音乐
打开 PDF 后,Audiveris 会创建一个 Book,为每幅图像建立一个乐谱页占位项。引擎可以独立处理各页,再由整本乐谱汇总结果。每一页都依次经过多个处理步骤,用户可以指定让处理流程推进到某个阶段。[2]
输入图像的质量始终影响后续处理。Audiveris 建议使用灰度扫描:普通 A4 或 US Letter 页面通常采用约 300 DPI,更有参考价值的目标是让相邻谱线之间保留约 20 个像素。细节不足会让有意义的记号消失;分辨率过高则会消耗更多资源,识别效果却未必随之提升。软件以检测到的谱线作为局部参照,即使谱线发生变形,也沿用这些参照,而不会自动把图像校直。[3]
五线谱因此也成了一把量尺。音符的位置需要相对于附近谱线来理解,识别系统只有先掌握页面的几何关系,才能可靠地解释上面的记号。音乐工作者若要把一份旧版印刷分谱转成可编辑乐谱,较清晰的扫描图就能为此后的每个阶段留下更充分的判断依据。
一团墨迹可以有多种解读
Audiveris 将一组前景像素称为 Glyph(字形)。在这一层,这组像素尚未获得音乐符号的身份,也尚未归属于某个谱表或谱表组。Inter 是 interpretation(解读)的缩写,它为像素提出一个候选身份,并标明其在上下文中的位置。同一个字形在最初阶段可以对应几种相互竞争的解读。[4]
图像含混时,这一区分尤其有用。音符附近的一处小记号,往往要等周边符号被识别出来,才有更充分的依据判读。Audiveris 可以暂缓选择,把候选解读保留到后续阶段,等待更多上下文。每种解读都有一项依据自身证据计算的内在评分;此后,支持它的关系还可以参与上下文评分。[4]
这套架构始终区分页面上实际存在的内容与引擎对其含义的判断。编辑器因此有了明确的校正目标:修改的是解读,背后的原始像素仍然可见。[6]
相邻符号为音符的识别提供依据
符号解读图(Symbol Interpretation Graph,简称 SIG)把每个谱表组内的解读连接起来。谱表组指同一行中需要一起阅读的一组谱表。图的顶点是 Inter 对象,边则表示关系。一个看起来合理的符头与附近的符干,可以借助 HeadStemRelation 相互支持。彼此不兼容的解读由排斥关系相连。中性关系可以描述成员归属,例如一个和弦包含多个符头。[5]
到了 REDUCTION 和 LINKS 阶段,程序会对图做约简,处理互斥关系,并移除上下文支持较弱的解读。一个符号能否保留下来,部分取决于它与相邻符号是否相容。识别单独的形状与组合出相互兼容的音乐符号配置,都会影响最终结果。[5]
编辑器的设计也由此展开。它直接操作解读及其关系,同时允许用户修改容纳这些内容的部分组织单元,例如谱表组和小节。人工校正页面时,使用的正是识别引擎建立的那套模型。[6]
一个错位的附点,会影响节奏计算
节奏处理阶段让这些依赖关系变得具体。在 5.11.0 版实现中,RhythmsStep 经由 PageRhythm 处理时值与节拍。程序处理编辑操作的影响时,会区分两类改动:一类只影响一个小节栈,即各声部纵向对齐的一组小节;另一类则要求重新检查整页。附点属于前一类,拍号对象属于后一类。[8]
实用指南给出了一个贴近读谱经验的例子:若明显问题已修正,小节仍然无法通过节奏检查,就应查看是否有附点缺失或识别错误。视觉上极小的差错,足以让一个小节的总时值出错。同一份指南还提醒,倚音一旦被误认作普通音符,就会被错误地计入节奏构造。[7]
这些例子提示了一种排查顺序:遇到节奏问题,先检查其背后的音乐符号依据,再考虑导出环节。它们也说明,草率添加替代解读有时会带来麻烦。指南建议先移除错误解读,以免因选取像素时的细微差别,让相互竞争的解读一起留在输出中。[7]
保存结果,也保存校正过程
Audiveris 生成两种分工不同的文件。.omr 项目文件保存整本乐谱及各页的识别状态。它内部是一个包含 XML 和乐谱页图像的 ZIP 归档,将整本乐谱的信息与可按需加载的细节分开存放。这样的组织方式便于保存和恢复工作,处理较大的乐谱集时,也可以避免把每一页的全部细节同时装入内存。[9]
.mxl 导出文件则是供其他应用读取的压缩 MusicXML。默认情况下,导出整本乐谱时,每个检测到的乐章都会生成一个独立文件。Audiveris 也支持 opus(作品集)导出,不过文档提醒,编辑器对此格式的支持有限。[10]
顺着这套设计,实际工作中适合把输入扫描图、.omr 项目与导出乐谱放在一起保存。扫描图留存原始依据,项目文件保留校正工作,MusicXML 则把得到的记谱内容交给后续软件。日后排练若发现某个乐段存疑,这些文件各自对应不同的核查需要。
文件能够播放,仍需有人读谱核对
独立研究说明,仅以成功导出作为检验还不充分。Pau Torras、Sanket Biswas 和 Alicia Fornés 在 2024 年的一项评估研究中,使用 Audiveris 5.3.1 检验他们提出的表示与评估框架。在 52,884 个作为标准答案的小节中,40,622 个能与预测小节匹配,覆盖率为 76.9%。作者将预测结果的缺失归因于部分页面未能生成输出。[11]
这个数字只对应一个旧版本、一套数据集和一种匹配程序。它既不能说明当前版本的准确率,也不能代表音乐工作者可预期的音符正确率。它对评估方法的启示在于:只检查最终留下的输出,有时会漏看那些从未进入比较的内容。
对独立编曲者或小型合奏团而言,这套架构适合从一个工作量适中的试验开始:处理一段有代表性的乐谱,对照扫描图检查节奏与声部,估量校正所需的投入,再着手处理全谱。规模较大的档案项目,则要在统计转录错误的同时,明确记录遗漏的页面与小节。Audiveris 让识别过程中的解读可供查看和修改;一份可信的成品乐谱,仍有赖于人核对,确认纸面上的音乐经过转换后得到了完整保留。
来源
- Audiveris,手册——项目范围、许可证、识别编辑器与支持的记谱法;适用于 5.11 及后续版本的文档。
- Audiveris,“处理流程”——整本乐谱与单页处理、步骤顺序及状态保存。
- Audiveris,“扫描”——灰度采集、分辨率与谱线几何关系。
- Audiveris,“Glyph 与 Inter”——像素依据、候选解读与评分。
- Audiveris,“符号解读图”——支持、排斥、包含关系与图约简。
- Audiveris,“基本原则”——编辑器共用的解读模型与可编辑的容器。
- Audiveris,“使用技巧”——附点、倚音与替代解读。
- Audiveris,
RhythmsStep.java,5.11.0 版——节奏处理与编辑操作触发的重新计算范围。 - Audiveris,“.omr 文件”——项目持久化、XML 组织、乐谱页图像与内存管理。
- Audiveris,“.mxl 文件”——压缩 MusicXML、乐章导出与 opus 兼容性。
- Pau Torras、Sanket Biswas 和 Alicia Fornés,“用于评估光学乐谱识别系统的统一表示框架”,IJDAR 27(2024),379–393——使用 Audiveris 5.3.1 的独立评估。
- 美国国会图书馆,“斯科特·乔普林与奇妙的《枫叶拉格》”(2024)——Shawn Miller 拍摄的初版乐谱片段;图片来源。