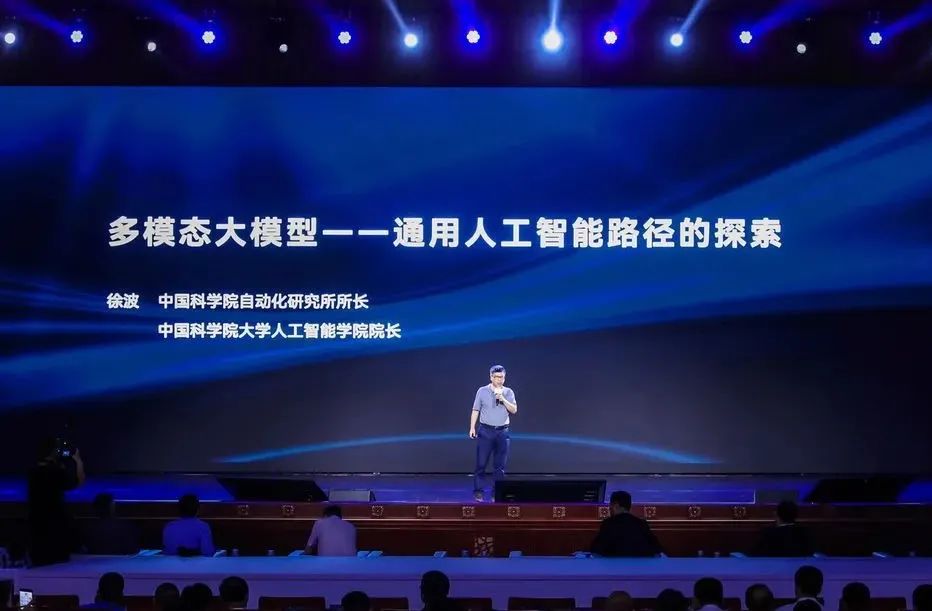
2021 年 7 月,中国科学院自动化研究所在世界人工智能大会上展示了名为“小初”的虚拟主持人。紫东太初平台能够联通图像、语音与文本,在同一项研究计划中开展视频描述、图像检索和问答。研究的目标,是让这些不同形式的信息协同发挥作用。[1]
五年后,这项计划的最新公开版本提出了一个更贴近物理世界的问题:物体在哪里,接下来会发生哪些变化?2026 年 9 月 15 日发布的 ZDTaichu5.0-9B,着眼于空间理解,以及服务于机器人和科研自动化的规划能力。[5] 项目延续至今的过程值得关注:实验室逐步调整多模态模型需要理解的内容,也随之改变达成目标所用的技术手段。
名称背后的研究部门
紫东太初隶属中国科学院自动化研究所,其专门的研究中心于 2022 年成为独立建制的研究部门。研究所介绍,该中心的研究范围覆盖视觉、语言、模式识别及相关应用,目标是建立面向复杂环境的共性人工智能平台。[2]
这样的组织安排,有助于理解项目何以持续。对于一项长期研究计划,发布模型只是其中一类成果,同样属于成果的还有培养出的研究人员、部署方法和合作关系。沿着版本号梳理紫东太初时,也需要看到将这些工作连在一起的研究机构。
早期公开的代码仓库,让最初的技术思路变得具体。它的 OPT 架构为各个模态分别设置编码器,另设一个跨模态编码器和两个跨模态解码器。训练目标分布在 token、模态和样本三个层级。也就是说,系统既要从每类输入中学到有用的表征,也要学习不同输入之间的联系。[3]
仓库还记录了当时的工程环境:华为昇腾硬件、CANN 5.0.4 和 MindSpore 1.6.1。这些历史环境要求属于当年的发布版本,与当前模型的安装指南应分开看待。仓库说明将公开代码对应的十亿参数量级模型,与项目宣布的更大规模模型作了区分。[3] 从项目早期开始,研究发布所强调的成果,与其他团队能够实际运行的代码和模型,就需要分别考察。
输入中纳入更多现实世界的信息
到 2023 年 6 月 16 日发布 2.0 版本时,研究所已明确将输入从图像、语音和文本扩展至视频、信号和三维点云。报道介绍了音乐、场景分析和三维环境导航等演示,也列出了昇腾基础设施和武汉人工智能计算中心在研发中的参与。[4]
这项变化分量很重,因为理解一个房间与生成一段图像描述,面对的是不同的问题。描述一把椅子之后,还要判断它是否挡住通道;识别出两件物体之后,还要判断哪件伸手可及。这些例子只用于说明空间推理的研究动机,2023 年演示的能力范围仍以当年的报道为限。
当时,研究所的介绍已经将多模态研究与物理设备的应用联系起来。[4] 此后工作中贯穿的一个问题是:模型要表征当前状况中的多少信息,其输出才能对另一个系统有用?
规模较小的新版本,沿用已有组件的能力
2026 年的模型卡把模型组成交代得格外清楚:语言主干采用 Qwen3.5-9B,视觉编码器采用 C-RADIOv4-H,输入包括文本、图像和视频。[6] 项目历代宣传的模态范围,与这个特定模型检查点的原生输入范围,需要区分开来。
对实验室而言,这套架构提示了另一种研究重心。已有的语言和视觉组件可以作为起点,研究贡献则可以体现在组件之间的连接、训练材料的选择,以及空间判断能力的改进上。这一解读依据的是已公布的设计,不能据此认定团队自行重建了每个组件。
团队公布的结果呈现了潜力,也显示出表现上的差异。模型卡报告,ZDTaichu5.0-9B 在 ViewSpatial 上得分为 62.50,Qwen3.5-9B 为 48.20;在 CV-Bench 上则略低,分别为 86.82 和 87.19。这些都是开发团队自行报告的基准成绩。多图像空间测试所列的提示词,要求模型给出中间推理过程,并将最终答案放在方框内。这组成绩初步反映了模型在该评测条件下的空间能力提升,机器人任务完成率仍需另行测量。[6]
实验室能够交给别人的成果
研究所 9 月的公告强调,随模型一同分享的还有空间数据生产流程,从材料清洗和筛选,到标注、微调和强化学习。[5] 对研究机构而言,这是一项重要的目标:其他实验室的摄像头视角和设备,会与已发布模型检查点训练时所用的材料存在差异。
项目页面更具体地介绍了训练顺序:从广泛的视觉与语言对齐,逐步转向更长的上下文、复杂指令,再通过核验答案、空间定位和输出格式开展强化学习。[7] 公开训练方案,有助于说明这些能力预期如何迁移到其他团队的工作中。至于其他团队是否已经复现整套流程,还需要另外的证据。
同一页面明确注明,成对展示的 LIBERO 机器人操作演示,均为挑选出来的单次运行。每组对比中的模型使用相同的初始状态和其他测试条件,但少数成功操作所能说明的范围有限,工厂或实验室中的整体可靠性仍待检验。[7] 下一步有价值的证据,应来自陌生布置下的反复试验,包括抓取出错或环境变化之后如何恢复操作。
模型卡还划定了一项重要的职责:配套应用必须负责工具执行,并验证执行结果。[6] 模型给出的空间判断,还要转化为经过授权的动作,系统也要观察动作是否奏效。
对紫东太初而言,这项长期研究计划的下一阶段因此格外值得关注。实验室的工作已从联通描述世界的不同方式,逐步走向表征在世界中采取行动所需的条件。接下来要看,外部团队能否将这种理解能力适配到自己的设备上,并报告可重复的结果。届时,这项研究计划便会从发布现场走进其他团队的日常工作。
来源
- 中国科学院自动化研究所,《多模态大模型:探索通向通用人工智能之路》,2021 年 7 月 9 日——最初发布时的中文报道、小初演示及活动资料照片。
- 中国科学院自动化研究所,《紫东太初大模型研究中心》——机构介绍及研究中心于 2022 年成立的情况;查阅于 2026 年 10 月 15 日。
- MindSpore AI,“ZiDong-Taichu / OPT”公开代码仓库——早期架构、当时的昇腾及 MindSpore 环境,以及所发布代码的范围。
- 中国科学院自动化研究所,《紫东太初全模态大模型正式发布》,2023 年 6 月 16 日——2.0 版本演示、扩展后的模态及算力合作方。
- 中国科学院自动化研究所,《紫东太初 ZDTaichu5.0 9B 开放发布:帮助 AI 理解三维物理世界》,2026 年 9 月 28 日——9 月 15 日的发布日期、空间能力重点及数据流程共享的相关说明。
- TaichuAI,“ZDTaichu5.0-9B”官方模型卡——模型组件、输入模态、基准成绩及提示词条件,以及应用对工具执行所负的责任;查阅于 2026 年 10 月 15 日。
- ZDTaichu 团队,《ZDTaichu5.0-9B:从视觉理解到空间智能》官方项目页面——训练阶段,以及页面对精选 LIBERO 对比演示所作的限定;查阅于 2026 年 10 月 15 日。