截至 2026-05-31 UTC,观察智谱在中国 AI 市场的动向,GLM-5.1-HighSpeed 宣称的输出速度值得关注,公司对延迟的重视也同样鲜明。智谱正尝试让智能体在选择模型时,把延迟作为独立的路由依据。BigModel 官方文档将它定义为 GLM-5.1 的高速版本,称其优化了推理引擎、调度系统和基础设施,输出速度达到 400 tokens/s。目前,这款模型在 BigModel 平台上仅向部分企业客户开放。[1]
访问限制决定了该怎样理解这项速度声明。这是厂商针对生产服务作出的声明,所用企业 API 设有准入门槛,尚待公开端点让开发者普遍复测。现有材料更能说明智谱的产品意图:把旗舰模型的能力与低延迟放进同一条产品线。若实际负载下也能兼顾两者,负责模型路由的团队就会在“聪明但慢”和“快但浅”之外多一种选择。他们需要检验,高速调用能否满足编码智能体和实时界面的要求,以及能否让频繁调用工具的任务在各步骤之间顺畅衔接。
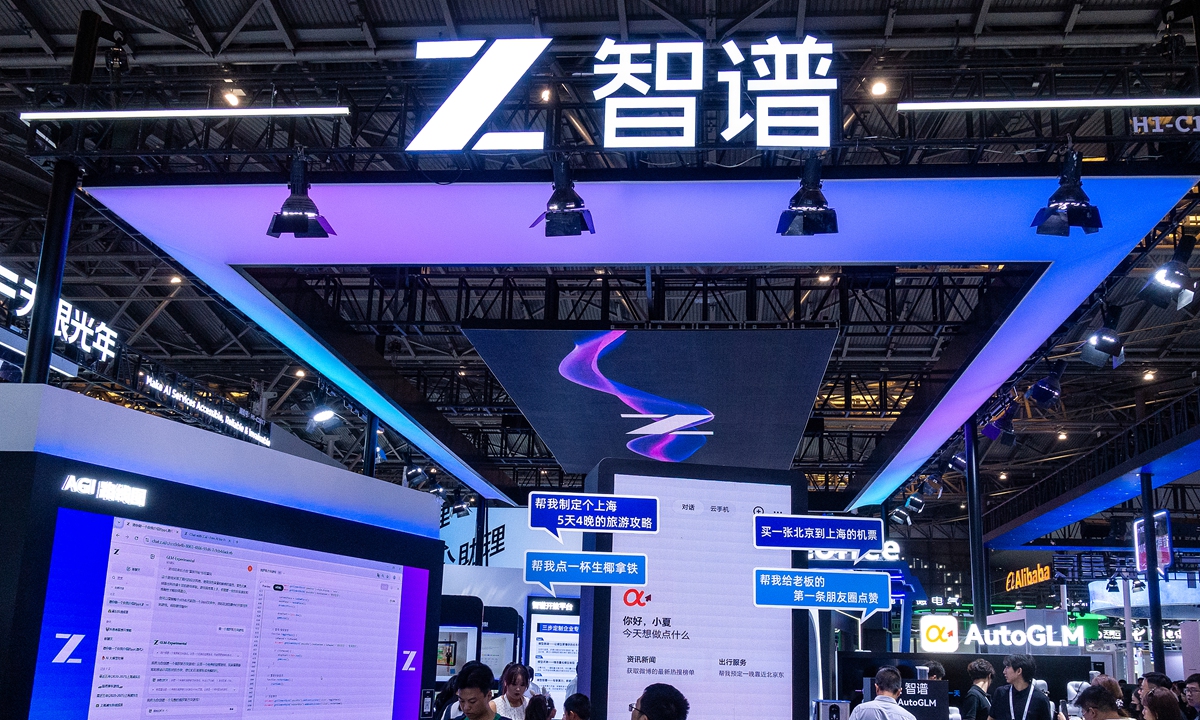
图片背景:封面是《环球时报》拍摄的 2025 世界人工智能大会智谱展台照片。相较于生成图、图表、示意图或通用 AI 插画,现场照片让读者看到具体的公司与展会,也呼应了本文对智谱平台策略和产品布局的讨论。[6]
发生了什么变化
GLM-5.1-HighSpeed 延续了 GLM-5.1 的产品定位。Z.ai 英文开发者文档将 GLM-5.1 列为面向长时间任务的旗舰基础模型,标明 200K 上下文长度、最多 128K 输出 tokens,并强调编码、工具使用和持续自主执行任务的能力。[3] 高速版本沿着这个方向,进一步追问实际使用中的问题:在用户仍能顺畅交互的等待时间内,智能体究竟能完成多少工作。
官方中文页面列出了流式输出、函数调用(function calling)、上下文缓存、结构化 JSON 输出和 MCP 工具接入等功能。[1] 每个环节的等待都会累积到智能体的总响应时间里。编码助手要规划任务、调用工具、查看文件、修改补丁、运行测试,还要在出错后恢复。实时 UI 生成器则要随着用户调整要求,反复更新界面。语音助手留给解码的时间更短,因为每轮交互还要花时间识别和合成语音。
智谱和 TileRT 对高速 API 的介绍,都强调了模型之外的系统改进。BigModel 页面称,这项工作涵盖推理引擎、调度和底层基础设施。TileRT 技术博客则认为,推理的瓶颈正从总吞吐量转向端到端响应速度,在智能体、语音交互、代码补全、工具调用和推理时扩展计算(test-time scaling)中尤其突出。[1][2] 从发布方式也能看出产品定位的变化:厂商以一整套执行系统的定位来推介这款产品。
怎样评估延迟声明
评估 400 tokens/s 这项厂商声明,需要先看清测试条件。官方页面强调稳定的生产能力,关注点也包括峰值之外的表现。但页面尚未公布完整的第三方测试工具、请求组合、硬件物料清单,也未给出可供独立复测的公开测试端点。[1] CnTechPost 在 May 22, 2026 报道了此次发布,提到该 API 仅向部分企业客户开放,智谱将其定位于对延迟敏感的 AI 编码、实时交互和商业决策应用。[5]
现有证据尚不足以认定“GLM-5.1-HighSpeed 已经是所有负载中最快的模型”。可以看出的是,智谱正尝试把竞争焦点从排行榜名次移到实际服务表现。为智能体选择模型时,除了平均输出速度,团队还要测量首 token 时间、尾部延迟和流式输出的平滑度,也要检查限速、缓存命中、工具调用可靠性、上下文窗口压力,以及长时间、多步骤任务的完成质量。
TileRT 的博客解释了响应速度与基础设施的关系。文章认为,以吞吐量为先的旧式推理服务设计,会掩盖一些固定开销;解码任务则会暴露内核启动、同步、内存访问、通信暂停和运行时调度间隙带来的等待。[2] TileRT 给出的方案包括持久执行、tile 级调度、warp 与 block 专门化,以及面向 GLM-5.1 注意力计算的异构 worker 设计。其性能声明仍需审慎评估,但技术方向已经清楚:智谱的模型研发正在与编译器、运行时和集群运行方式更紧密地结合。
这对中国 AI 竞争有何影响
中国 AI 市场已有众多模型家族,Qwen、DeepSeek、Kimi、GLM、MiniMax、ERNIE、Hunyuan、InternLM 等项目的发布周期还在缩短。下一步的持久优势会更多来自日常使用:供应商能否让能力强的模型响应够快、费用够低、表现足够可预期,让它进入人们每天使用的工作软件。
价格是另一项考量。按本文写作时的文档,GLM-5.1 标价为每百万输入 tokens $1.4、每百万输出 tokens $4.4,缓存输入的价格更低。[4] 价格只是选择路由的条件之一,却决定了预算能容纳哪些选择。若模型足以胜任编码和智能体任务,高速通道又能缩短等待、将费用保持在预算内,智谱就能在延迟直接影响用户体验的工作中争取到客户。
实际采用还取决于基准成绩之外的体验。等待过久的模型,即使最终答案更好,也会拖慢协作式编码。静态测试成绩略低的模型,若能迅速流式输出、连续调用工具,让用户随时看清进展,也有机会被产品选用。延迟还会改变智能体的工作方式:中间步骤加快后,系统能尝试更多执行过程(rollout)、增加检查、提早澄清疑问,并让多个子智能体持续工作,同时保持界面交互连贯。
产品策略也与国产技术栈的选择相连。《环球时报》在 2026 年早些时候报道了智谱与华为在 GLM-Image 上的合作,同时谈到中国芯片、MindSpore 和昇腾 Atlas 硬件。[6] GLM-5.1-HighSpeed 是另一款产品,其文档尚未作出同样的硬件声明。两次发布仍能看出一致的公司定位:智谱试图展示模型研发之外的能力,把模型、部署基础设施与企业需求结合起来,并适应中国技术栈的具体限制。
选择模型时怎样考虑延迟
开发者若要全面切换到 GLM-5.1-HighSpeed,还需补齐评估依据。访问仍有门槛,基准测试的完整条件也尚未公开,仅凭 400 tokens/s 难以判断任务质量、出错后的恢复能力和工具调用是否正确。眼下可以先在设计路由表时单列延迟要求,把它放进最初的模型选择条件。
面向智能体工作的路由表至少需要四条通道:第一条负责低成本的后台总结;第二条负责允许较长等待的深度推理;第三条负责本地或私有数据任务,优先满足数据存放和访问限制;第四条负责交互式智能体任务,着重减少多轮操作累积的延迟。智谱明确瞄准第四条通道。[1][5]
这类任务会改变选择“最佳模型”的标准。在编码智能体中,响应慢但能力极强的模型仍然适合架构审查或最终验证。到了编辑、测试、调试反复交替的阶段,能让工作持续推进的模型,即使静态基准成绩未居首位,也能带来更高的整体价值。实时仪表盘、游戏生成、语音指导、客服辅助工具和多智能体商业分析同样如此:只要用户需要等待每一步结果,延迟就是能力的一部分。
还需要哪些证据
首先要看访问范围能否扩大。若 GLM-5.1-HighSpeed 向更多客户开放,外部团队就能用实际提示词、长上下文、工具调用和混合流量,检验厂商宣称的延迟表现。[1]
其次需要第三方运行跟踪记录,报告首 token 时间、输出稳定性、尾部延迟、错误率,以及与可比模型相比的任务成功情况。速度提升的价值取决于它能否同时守住可靠性,尤其是在智能体执行关键步骤时。
第三要看编码套餐、企业助手和实时交互工具是否采用它,用户能在这些产品中直接感知差异。Z.ai 已将 GLM-5.1 定位为适合长时间编码和自主执行任务的模型。高速版本若能在此基础上成为低延迟执行通道,产品价值也会更充分地体现出来。[3]
就现有材料而言,GLM-5.1-HighSpeed 显示了中国 AI 竞争的一项变化。模型发布仍受重视,而争取被路由系统选用,越来越依赖模型周围的基础设施:流式输出是否顺畅、缓存如何工作、调度和尾部延迟表现怎样、工具调用能否连续,以及价格是否合适。这些因素共同影响智能体工作的连贯性。智谱的 400 tokens/s 声明仍待更公开的证据和更广泛的复测,产品方向已经清楚。[1][2][4]
来源
- Zhipu BigModel docs, "GLM-5.1-HighSpeed"(官方中文产品文档,覆盖 400 tokens/s 声明、企业客户选择性访问、上下文规模、能力、场景和 API 示例)。
- TileRT Team, "Speed as the Next Scaling Law"(May 21, 2026;关于 TileRT、GLM-5.1 生产实践、持久执行、tile 级调度和延迟优先推理的技术博客)。
- Z.ai Developer Docs, "GLM-5.1"(官方英文模型文档,覆盖定位、上下文长度、最大输出 tokens、编码能力和长周期自主任务框架)。
- Z.ai Developer Docs, "Pricing"(GLM-5.1 输入、缓存输入和输出 tokens 的官方模型价格表)。
- CnTechPost, "Chinese AI startup Zhipu rolls out ultra-fast version of flagship model"(May 22, 2026;发布报道、企业可用性、速度声明和使用场景定位)。
- Global Times, "Zhipu AI open-sources advanced multimodal model trained on Huawei Ascend chips..."(Jan. 14, 2026;本文所用智谱 WAIC 展台照片来源页,以及智谱国产栈定位的背景)。