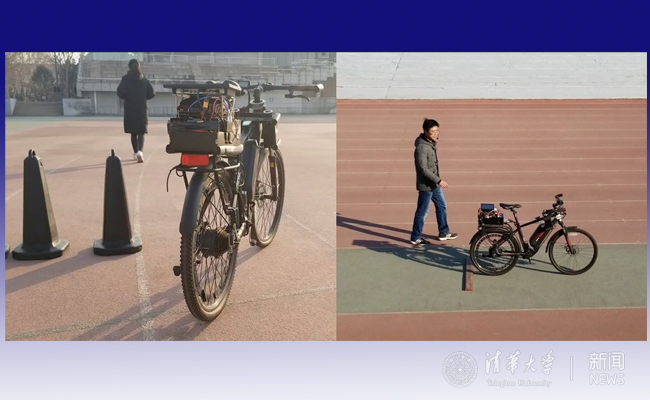
这辆自行车无人骑行,后货架上却挤满了设备。清华大学发布的照片里,电子设备架在后轮上方,自行车正沿跑道行驶。2019 年的这场演示,将语音识别、目标检测与跟踪、平衡控制、避障和决策集中到一个平台上,由一枚 Tianjic 芯片运行。[1]
自行车用于展示计算能力,格外有说服力:维持平衡有时间要求,感知结果必须及时送达。几项各有用途的计算结果,只有按时到齐,才能合成一次有效动作。沿着清华从 2019 年到 2022 年发表的研究往下看,演示背后的工程脉络逐渐清晰:先容纳不同的神经网络,再为软件建立可移植的描述方式,随后安排这些网络运行的时机。[1][2][3]
先让不同网络共用芯片
最初的 Tianjic 研究着眼于传统人工神经网络与脉冲神经网络之间的差异。后者以离散事件,也就是脉冲,传递信息。清华设计的混合架构能够运行这两类计算,也支持将两者组合起来。[1]
自行车演示的重点就在这种兼容能力。车上的各项功能可以共用同一个计算平台。清华同时公布了第一代软件工具链,用于自动完成模型映射和编译。[1]
接下来的问题要求更高:芯片即便能运行每一个网络,几个网络之间又该怎样分配资源?机器人需要各个部件运转得快,也需要它们配合得当。一项任务向另一项任务传递信息时,两者的时序就成了系统行为的一部分。
再让程序走出单一芯片
2020 年 10 月,张悠慧(Youhui Zhang)及其同事发表了类脑计算系统层次体系的设计方案。他们从兼容性问题出发:软件与硬件之间若缺少通用的对应关系,编程灵活性和开发效率都会受到影响。[2]
研究人员提出了一种软件抽象和一种抽象硬件架构,并引入一项名为神经形态完备性(neuromorphic completeness)的形式化性质。在这套层次体系中,程序可以用统一方式表达,并在满足该性质的硬件上编译成具有等价行为的程序。他们还开发了工具链,在多个硬件平台上演示了不同类型的程序。[2]
放到产业层面,这项研究让关注点有所转移。芯片演示即使引人注目,后续每个应用能否省下精细适配的工夫,仍是一个问题。借助中间表示,开发者可以先描述计算任务,再将其适配到特定机器。这篇论文建立了框架,并完成演示;至于程序能否在整个商业软硬件体系中轻松移植,还需要进一步验证。[2]
2020 年的这项工作,说明了软件层在这条研究线索中的位置。其结论所及有明确范围,后续各代 Tianjic 软件能否互换使用,仍需分别考察。
TianjicX 加入任务调度
2022 年 6 月发表的 TianjicX 研究,直接处理机器人的并发任务。其核心设计称为 Rivulet,用来描述神经网络中的计算活动如何保存数据、接收变化的输入,以及占用计算资源。任务可以从空间和时间两个方面共享硬件,并借助可配置的分组协调执行。[3]
具体说,这套设计同时回答两个问题:芯片的哪些部分来做这项工作,以及何时来做?不同任务可以有不同的安排。有些活动需要相互配合,另一些则可以独立进行。研究人员据此研制了一枚 28 纳米芯片,并开发了专用的编译器软件栈。[3]
演示设备也从自行车换成了 Tianjicat,一台玩猫捉老鼠游戏的移动机器人。目标识别、声源定位、避障和决策共同组成计算负载,其中几项任务彼此牵动。[3]
论文中的一个细节很能说明问题:一个脉冲神经网络充当声音处理的开关,系统在适当的时候启用声源定位网络,让计算随当时的需求启动。[4] 因而,工作负载本身也是分析效率的一部分。机器选择运行哪些计算,与它运行得多快同样值得关注。
看加速幅度,也要看对应的负载
作者报告,以计算延迟衡量,TianjicX 相较 NVIDIA Jetson TX2 GPU 的加速比达到 79.09 倍,动态功耗降低了 50.66%。这组结果来自论文中的特定多网络实验。作为对照的 TX2 串行运行各个网络,TianjicX 则采用并发、异步、事件驱动的执行方式。[4]
理解这一结果,需要把比较范围看清楚。实验将一套包含执行策略的系统设计,与一种特定的实现方式作比较。至于每个神经网络在 TianjicX 上是否都能达到这样的加速幅度,或机器人完成整项任务是否也能快这么多,这项实验尚未给出证明。
评估还明确考察了数据搬运。论文区分了计入数据加载与排除数据加载的延迟测量,并改变了 TianjicX 的数据传输条件。功耗结果指向芯片的动态功耗,机器人电机、传感器及其他电子设备的耗电均在这项主要比较的范围之外。[4]
这些限定让研究贡献更清楚:研究人员检验的是,协调几个规模较小的网络,能否改善机器人的计算表现。回答这个问题,所需的证据超出了单一的峰值算力指标。
这条线索如何改变对中国 AI 技术栈的理解
对这一系列研究的一种解读是:当软件能够表达硬件所针对的计算工作时,硬件进步最能发挥作用。Tianjic 让不同类型的神经网络共用计算平台;层次体系研究处理程序表示和编译;TianjicX 则将资源分配和任务协调纳入设计。[1][2][3]
接下来,更有说服力的证据将来自独立复现、此前未测试的负载,以及覆盖机器人从感知到行动全过程的测量。这些证据将表明,论文报告的收益能在多大范围内延伸到演示之外。
那辆自行车仍是一个值得记住的画面。站在跑道边看,它的动作连贯而轻松。机器内部,许多细小任务必须按合适的顺序及时完成,并为转向留出足够时间,智能才有了实际用处。
资料来源
- 清华大学精密仪器系,《施路平教授团队在 Nature 发表封面论文——以混合 Tianjic 芯片架构迈向通用人工智能》,2019 年;介绍混合架构、软件工具链,并附官方自行车演示照片。
- Youhui Zhang 等,《类脑计算的系统层次体系》,Nature 586,378–384,2020 年 10 月 14 日;介绍软件与硬件抽象、神经形态完备性及工具链演示。
- 清华大学施路平教师个人网站,《TianjicX:具备时空弹性的神经形态芯片,用于边缘端实时多任务处理》,2022 年 6 月 15 日;中文第一手研究公告,附英文摘要。
- Songchen Ma 等,《面向多智能任务机器人的时空弹性神经形态计算芯片》,Science Robotics 7,eabk2948,2022 年 6 月 15 日;作者网站提供的论文全文,重点参见 Tianjicat 实验及展示延迟与功耗的图 6。