光可以在光学电路中完成计算,但电路规模扩大后,一个棘手的问题随之出现:物理误差有沿途累积的风险。神经网络要具备实用价值,除了速度,还得足够准确地完成预定计算,才能得出正确答案。[1]
清华大学的太极研究从任务分工入手处理这一问题。2024 年 4 月发表的芯粒论文探索了分布式光学架构,同年 8 月在线发表的第二篇论文则研究如何直接在物理光学系统上学习。[1][4] 将两项实验放在一起看,可以看到中国 AI 硬件研究的一个重要方向:寻找与物理介质特性相适应的计算体系。
让光计算向宽度展开
最初的太极设计结合了两种光学技术:衍射承担高度并行的处理,干涉承担可重构计算。研究人员将两者纳入编码、特征处理和解码的流程,再用分布式协议把较大的任务拆成较小的部分。[2]
清华大学将这种做法描述为向宽度扩展。一个大问题被分解为一组子问题,分别交给光子芯粒处理,再汇总各自的结果。这样可以应对一项难题:复杂计算若要经过越来越深的物理操作链,每个环节的误差都会增加完成计算的难度。[2]
对于习惯阅读处理器规格的读者,这里的要点在于分工。架构决定了各个光学部件接到什么任务,以及如何把分散的计算结果重新组织成可用的答案。高速部件有了周边环节的配合,才有条件处理更大的任务。
这些芯粒还把几种容易被分开讨论的物理功能结合起来。太极的贡献包含了这些功能之间的联系:输入如何编码、如何变换,又如何还原为输出。正是这种联系,让这项研究除了器件本身,也值得放在计算基础设施的层面讨论。[2]
读数字,也要看实验条件
4 月的论文报告了 每秒每瓦 160 万亿次运算的能效,以及在 1,623 类 Omniglot 字符分类任务上达到 91.89% 的准确率。这些数字来自作者的光计算实验,具体展示了更大规模光子计算的实验成果,测量范围尚未涉及当代语言模型的服务成本。[1]
配套发布的数据让实验范围变得格外清楚。研究团队在 Dryad 上提供了经过预处理的 CIFAR-10、mini-ImageNet、Omniglot 和巴赫众赞歌数据集。说明文档记载,图像经过尺寸调整或裁剪,训练集与测试集的划分经过重新编排,输入也按光学硬件的要求作了适配。[3]
这些准备工作也是系统的一部分。基准测试使用熟悉的数据集名称,仍不足以保证两台机器收到相同的输入,或遵循相同的评估流程。要作比较,就得同时核对实际的数据预处理、训练与测试划分、模型以及测量方法。
因此,这份数据资料除了帮助复现实验,还揭示了通用数据集转变为器件可接受任务的具体环节。对于一种新兴计算平台,这种转换本身就是工程成果,也是理解所报告结果时必须一并考虑的前提条件。[3]
让物理系统参与学习
8 月的研究处理了另一项依赖:借助数字仿真训练光学神经网络,前提是模型能足够准确地描述物理装置。建模系统与真实系统之间的偏差,会影响计算能否按预期完成。[4]
研究人员提出的全前向模式(fully forward mode)方法,利用空间对称性和光学互易性,经由前向传播获取学习所需的信息。数据和误差信号穿过物理系统,测得的光场则用于计算梯度、更新参数。[4]
这里的区别关系到训练如何完成。训练仍然包含目标、误差和参数更新;这项工作的贡献,是从物理系统中获取更新所需的信息,从而减少对数值建模的依赖。论文在自由空间光学系统和集成光学系统中都演示了这一方法。[4]
清华大学于 2024 年 8 月 9 日发布的中文公告,将这款训练芯片称为太极-II(Taichi-II),并明确区分了此前的推理研究与这次训练方面的进展。公告还提到从原型器件走向产业化的方向。[5] 这份带有明确日期的公告记录了当时的研究方向,完整商业平台是否已经可用,仍需另有证据。
下一步,测量整个平台
在我看来,两项研究最突出的共同贡献在于组织方式。一项把更大的任务分配给多个光学部件,另一项让物理系统更直接地参与学习。它们各自减轻了一项具体障碍,让具有吸引力的器件朝着实用机器又走近一步。
下一项有说服力的演示,应当让一个尚未尝试过的任务走完整个流程:输入预处理、训练或模型映射、光学执行,以及输出还原。演示还应报告完整任务的耗时与能耗,说明计入了哪些外围设备,并展示反复运行后能否保持结果。
这些测量也会让供应链问题变得具体:哪些部件需要定制制造?哪些调整需要实验室专业人员操作?哪些步骤可以由软件在另一台设备上可靠地重复?这些问题用于评估实际部署,尚不能据此认定两篇论文已经暴露了相应缺陷。
太极为这样的评估提供了扎实的起点。2024 年的实验展示了光学 AI 如何根据硬件特性重新组织计算与学习,进而扩大规模。接下来更长的一段路,是让这套组织方式具备足够的可复现性,供原实验室之外的人使用。
来源
- Zhihao Xu 等,“Large-scale photonic chiplet Taichi empowers 160-TOPS/W artificial general intelligence”,《Science》,2024 年 4 月 12 日;原始研究摘要与发表记录。
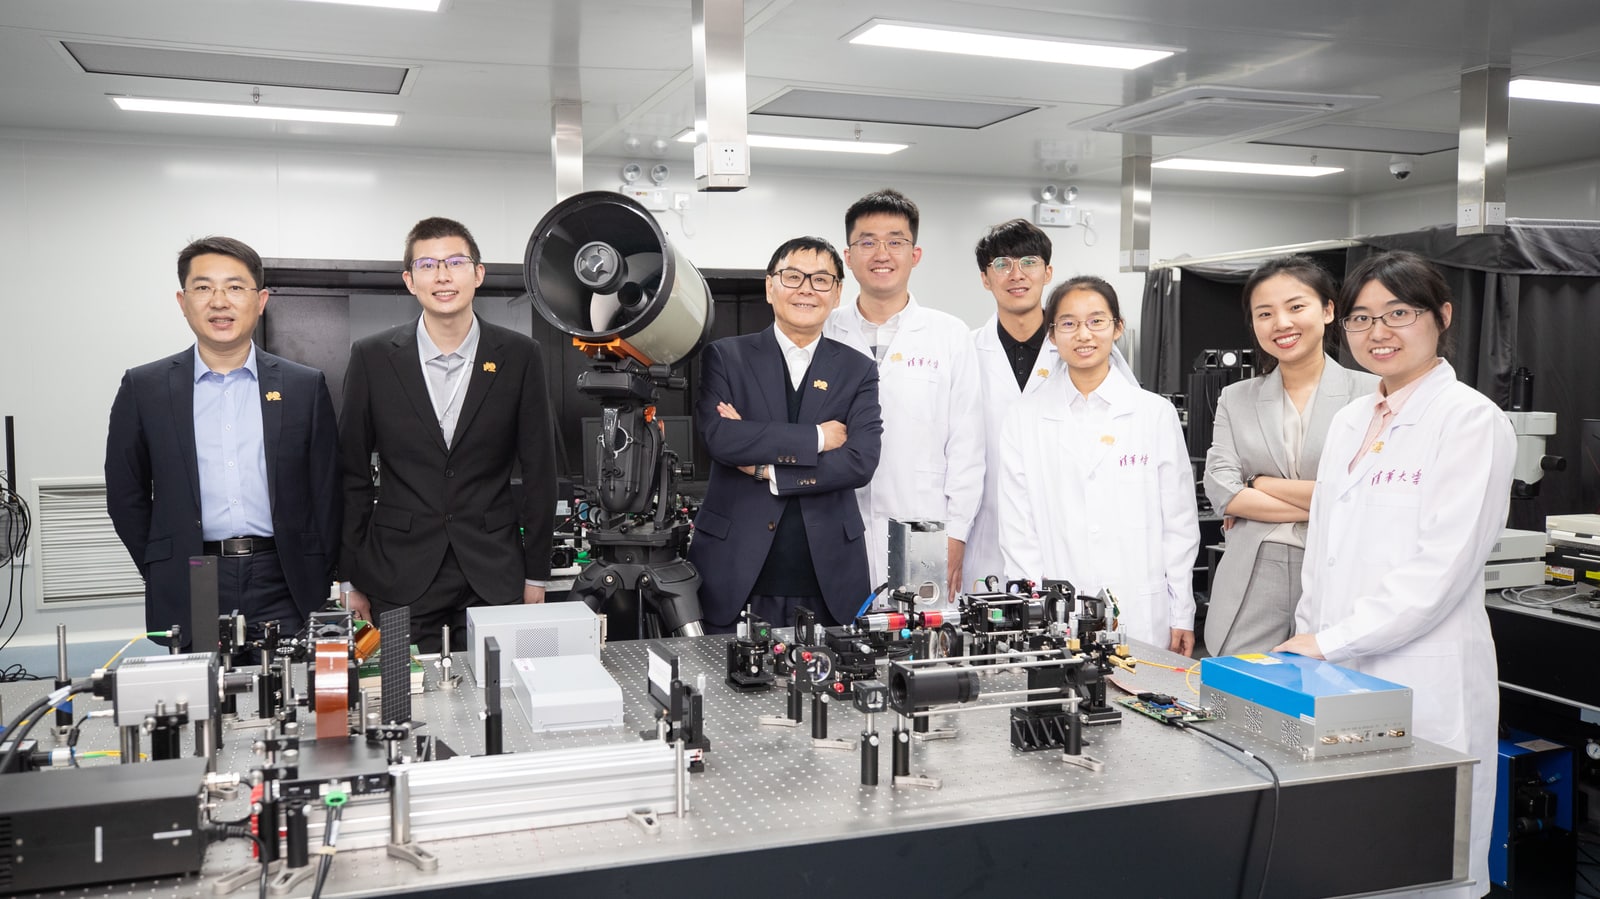
- 清华大学电子工程系,《太极简介》,2024 年;分布式架构、混合光子芯粒及实验室团队照片。
- Zhihao Xu 等,太极实验数据集,Dryad,2024 年 4 月 2 日;输入预处理、尺寸调整及训练集与测试集划分说明。
- Zhiwei Xue 等,“Fully forward mode training for optical neural networks”,《Nature》,2024 年 8 月 7 日在线发表;PubMed Central 收录的论文全文。
- 清华大学,《清华交叉团队推进智能光计算训练》,2024 年 8 月 9 日;关于太极-II 及其与此前推理研究关系的中文一手公告。