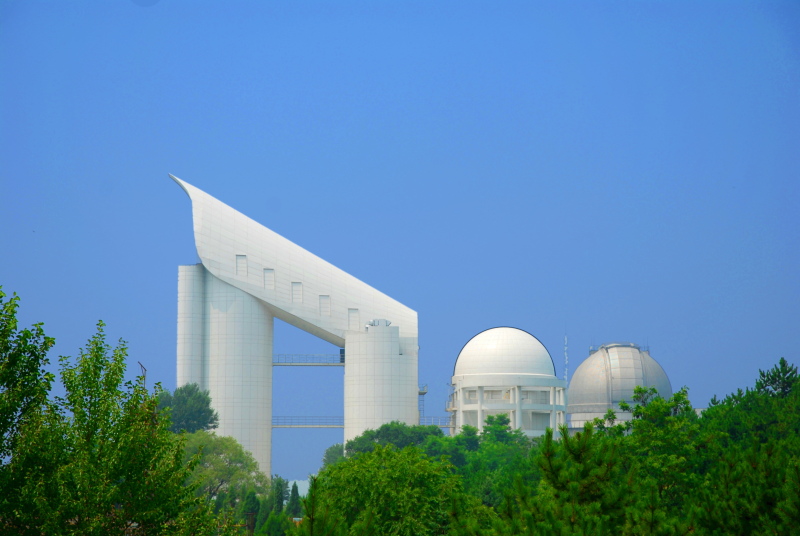
当一架望远镜的观测能够帮助检索另一架望远镜的档案,已有数据就多了一层探索价值。2026 年 9 月 14 日,中国科学院宣布向全球发布 LAMOST DR12 2.0 版,包含 2011 年 10 月至 2024 年 6 月采集的 2,807 万条光谱。[1] 每条光谱记录了天体的光随波长变化的情况。观测记录不断累积,科学上的难题在于,怎样把它们变成天文学家能够信赖的比较依据。
SpecCLIP 处理的是其中一部分难题。中国科学院国家天文台于 2026 年 2 月 24 日介绍了这一模型,它将 LAMOST 的恒星光谱与欧洲航天局 Gaia 任务的恒星光谱联系起来。[2] 将这项工作与档案发布、另一项把模型适配到 DESI 的实验放在一起看,可以看到科学 AI 的一种进展方向:让已有观测协同发挥作用。
同一片天空,不同的数据形态
LAMOST 此次公开的数据包含 1,260 万条低分辨率光谱和 1,547 万条中分辨率光谱。[1] 这里统计的是光谱条数,每条光谱未必对应一颗独立的恒星。这些数字描述的是观测档案的内容,SpecCLIP 训练集的规模需另作区分。
Gaia 带来了另一种观测视角。其 DR3 数据包含蓝光和红光光度计采集的低分辨率光谱,通常称为 BP/RP 或 XP 光谱。欧洲航天局介绍,这些光谱由每个天体的多次观测取平均得到,覆盖全天约 2.2 亿个天体。[3] 即便同样叫作“光谱”,背后也涉及仪器选择,以及多次观测如何合并。
国家天文台指出了实际障碍:各项巡天在波长覆盖范围、分辨率和观测方法上存在差异。研究设想是借助统一的表征方式,跨越这些差异,帮助科学家估计恒星性质、寻找异常天体。[2] 天文学家面对的是同一类物理天体的观测记录,需要找到一种比较方法,将各不相同的测量尺度衔接起来。
学会比较,也保留细节
SpecCLIP 首先分别学习两类光谱的表征,随后用 820,568 对 LAMOST 与 Gaia 光谱开展对比学习,使两类表征对齐:相互匹配的观测,其表征被拉近;不匹配的观测对,其表征被拉开。[4]
一味追求一致也有代价。当模型专注于两类数据的共性时,对某一仪器重要的特征就有丢失的风险。因此,SpecCLIP 加入了重建输入光谱的解码器,同时也用解码器从一类光谱预测另一类光谱。这些附加任务促使模型在共同模式之外,保留更多信息。[4]
这套方法对应着具体的操作流程。公开代码仓库演示了如何载入一条 LAMOST 光谱、建立可检索的表征数据库、找出相似的 Gaia 光谱,以及预测对应的 Gaia 式光谱。[5] 研究者可以从一个实际观测样本出发,在档案中寻找与它相似的候选天体。
设想一位学者正在为一颗异常恒星组建比较样本。检索结果若按相似程度排序,可帮助缩小下一轮检查的范围。研究者仍需逐一审视观测记录,确认每个候选天体的研究价值,再决定是否值得追加测量。这是对检索如何辅助研究的推演,尚未声称这次检索已发现新的恒星族群。
预测光谱还需要单独标注。预测结果出自模型,检索得到的光谱则来自所查数据集中的实际观测。[5] 如果把两者混用,就会抹去研究流程中必须保留的区别:望远镜测到了什么,模型又预期会看到什么。
第三架望远镜带来更难的检验
另一项发表于 2025 年 7 月的研究,尝试用低秩适配(LoRA)将 SpecCLIP 适配到 DESI 早期数据发布中的光谱。这项技术保持原有模型权重固定,只训练小规模的权重更新。实验以 APOGEE 的测量结果为参照,估计恒星的铁丰度;所用标注数据中,89 颗恒星用于训练,9 颗用于验证,396 颗用于测试。[6]
部分适配方案改善了整体结果,测试集中的 60 颗贫金属恒星却呈现出较差的表现。所有受测方法在这一子集上都遇到了困难,相比表现最好的未适配基线,LoRA 各方案的结果离散程度反而有所增加。实验使用的是经过筛选的 DESI 数据,还将光谱重采样到了 LAMOST 的波长网格上;据此能够评估的迁移效果仍限于这些条件,自动迁移到任意望远镜数据的能力尚待验证。[6]
这种表现差异直接关系到预期的科学用途。国家天文台的介绍把寻找极贫金属恒星列为值得期待的应用之一。[2] 模型即便在占多数的恒星上表现改善,在专业研究者关注的稀少类别上也仍有实用性下降的风险。由此推断,下一项有说服力的成果应当直接衡量罕见天体检索的成效:多少候选天体经后续观测得到确认,又有哪些类型的恒星被遗漏。
观测档案模型需要怎样的实证
SpecCLIP 原始论文在一个包含 82,057 条光谱的测试数据集中演示了检索,并将查询光谱本身排除在检索范围之外。论文也承认,参数估计存在受虚假相关性影响的风险,模型的可解释性仍需进一步检验。[4] 这些说明限定了演示结果所能支持的判断。
公开材料的完备程度也划出了一道实际界限。截至 9 月 23 日核查时,代码仓库已提供预训练模型,以及可供操作的检索和光谱预测示例,参数预测教程仍标注为即将发布。[5] 已发表的研究能力与当前已有文档、可供复用的具体流程,需要分别看待。
综合这些进展,可以看到一条要求很高、也有望带来成果的研究方向。更大的公开档案汇集观测记录,共享表征让新的比较成为可行之事,迁移实验则揭示这些比较在哪些地方失效。衡量成效的一项实用标准,是检索之后完成了怎样的科学工作:比较样本是否更合适,异常恒星是否得到确认,或者估计结果能否复现,并如实报告其不确定性。
SpecCLIP 的吸引力在于,一座天文台长期积累的观测,可以帮助研究者向另一份档案提出更有价值的问题。它的下一项成绩,要由天文学家能够验证的答案来确立。
来源
- 中国科学院,《LAMOST DR12 数据集向全球发布》,2026 年 9 月 14 日;2.0 版、观测时段,以及低分辨率和中分辨率光谱数量。
- 中国科学院国家天文台,《研究团队发布 SpecCLIP,助力银河系考古》,2026 年 2 月 24 日;关于跨巡天分析及拟议科学应用的中文一手介绍。
- 欧洲航天局,《它们是什么颜色?Gaia DR3 中的蓝光和红光光度计数据》;已发布 BP/RP 光谱的覆盖范围及观测平均方式。
- Xiaosheng Zhao 等,《SpecCLIP:恒星光谱测量的对齐与转换》,arXiv 第 4 版,2025 年 12 月 19 日,已获《天体物理学杂志》接收;对齐数据、光谱重建、检索设置及可解释性讨论。
- Xiaosheng Zhao 及合作者,SpecCLIP 官方代码仓库;预训练模型、检索与光谱预测示例,以及教程发布状态,访问日期为 2026 年 9 月 23 日。
- Xiaosheng Zhao 等,《使用 LoRA 微调恒星光谱基础模型》,2025 年 7 月 28 日;DESI 适配实验、样本筛选、标注数据划分及贫金属子集结果。
- Paul Hilscher(Sheliak),《LAMOST telescope org.jpg》,2008 年 7 月,维基共享资源;800 × 536 原始照片、作者署名及 CC BY-SA 3.0 许可。