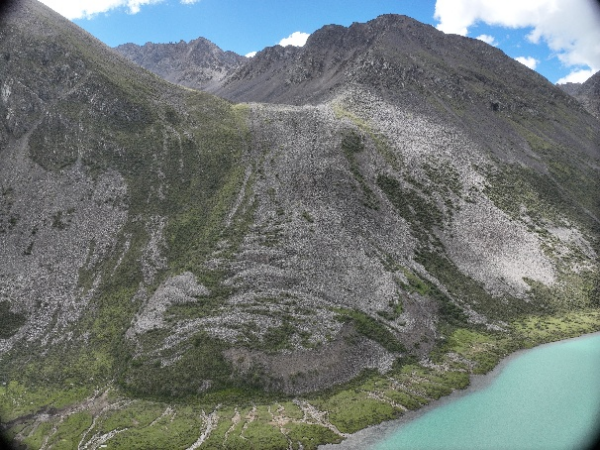
同一片山地在数据库里增加了数千条记录,山地本身却仍是原来的样子。阅读中国日益扩充的 AI 辅助岩石冰川编目时,需要先记住这一点。2024 年发布的 TPRoGI 收录了 44,273 个岩石冰川单元。到 2026 年 8 月,中国科学院青藏高原研究所公布了另一套编目 TPRGI,其中收录了 132,867 个单元。[1][2]
两个名称相近,很容易让人直接比较总数。它们分属不同的研究项目,采用的制图标准也各有差异;据此认定山地冰体成倍增加,缺少依据。结合较新的区域研究来读,这些编目揭示了一个更有用的问题:模型提出一条轮廓后,还要经过哪些工作,才能把它确认为可供其他科学家研究的地貌。
怎样算作一个岩石冰川单元?
岩石冰川由含冰碎屑沿山坡缓慢蠕动而成。表面的石块覆盖,让它们比裸露的冰体更难辨认。[1] 绘制岩石冰川分布图,需要确定一处地貌从哪里开始、到哪里结束,还要判断相邻的舌状体应归为一个单元,还是分别计数。
2024 年的 TPRoGI 研究由香港中文大学研究人员牵头,使用 DeepLabv3+ 从 Planet 卫星影像中识别候选地貌。研究范围排除了兴都库什—喜马拉雅地区,制图规则也排除了面积小于 0.01 平方千米的地貌。随后,人工制图人员修正边界,并在相接单元的边缘清晰可辨时,将它们分开标绘。[2]
模型性能的数字也要结合具体任务理解。在整个研究区内,模型的 F1 分数为 0.63,依据预测区域与经人工完善的编目之间的面积重叠情况计算。计算涉及正确标绘、遗漏和误纳入的面积。“每条最终边界都有 63% 的准确率”,超出了这个分数所表达的含义。[2]
因此,编目总数总是与统计方法相连。要解释两套编目的数量差异,研究人员需要先比较覆盖范围和计数规则,再逐一匹配其中的实际地貌。直接将公布的总数相减,就跳过了这些工作。
人工增补也会改变计数对象
2026 年 6 月发表的一项东喜马拉雅研究,详细呈现了人工修订的过程。研究中的 UNetFormer 模型最初生成了 8,206 个多边形。经删除、边界调整、拆分、合并和增补后,最终发表的编目包含 10,552 个单元。作者提醒,将新增的 4,600 个单元全部算作模型漏检,会混淆两种情况:审核人员能够使用更精细的影像,一些地貌在其中可被辨认,模型所用的 PlanetScope 输入影像则受分辨率所限,难以将其分辨出来。[3]
这直接关系到如何评价自动识别的效果。制图人员拿到更清晰的影像,也就获得了新的证据。若把最终编目与最初预测直接对照,模型本身的表现与影像所能呈现的地貌差异,就会被混在同一项评价里。
这项研究还提供了两个彼此关联的图层:一个记录单个岩石冰川单元,另一个记录相连单元组成的较大系统。同一处山地地貌,在不同图层中可以对应不同的计数结果。选择哪一种表达方式,取决于研究所需的分析尺度。[3]
模型扩大搜索范围,核查也随之展开
2026 年 8 月,另一项青藏高原东南部研究借助更多样的训练数据,扩大了搜索范围。Xin Guo 及其同事汇集了世界各地的 19,096 个岩石冰川样本,用于训练 SegFormer。最终的区域编目收录了 47,916 处地貌。[4]
在使用这套覆盖更广的训练数据之外,研究人员还检查预测多边形,将存疑案例交由专家审核,并与更高分辨率的影像及现有数据集核对。团队在三个地点开展了无人机辅助野外调查,为评估边界的可靠性补充了实地样例。[4]
这种配合为中国科研领域的 AI 应用提示了一个方向:模型让大范围搜索成为切实可行的工作,野外观察则帮助研究者确认模型识别出的究竟是什么。三个调查地点带来了有价值的核查依据,其覆盖范围仍限于这些地点,与逐一踏查所有已标绘地貌之间有明确距离。这项工作的价值,在于把不同尺度的观察衔接起来。
从平面轮廓到移动的地貌体
TPRGI 又增加了一类观测。中国科学院青藏高原研究所将深度学习与多期雷达观测结合,报告称已获得编目中 99.3% 单元的地表形变测量结果。[1] 这一比例说明测量覆盖了多少单元;快速移动或存在灾害风险的单元占比,则是另一个需要判断的问题。
当地图被用于讨论水资源时,这一区别更为突出。北京大学一项针对 Guokalariju 地区的独立研究发表于 2024 年 1 月,依据标绘面积、模型估算的厚度以及含冰量假设,估算地下冰储量。采用不同的厚度估算方法,所得储水量相差很大。[5]
这项区域研究提醒人们留意从地图推算储量时的局限,并未说明 TPRGI 所用的具体方法。一条轮廓能限定地貌的面积;估算其下方的冰量,需要补充信息;进一步估算水何时能够流入河流,又需要更多资料。编目可以指引这些调查,相关答案仍有待调查得出。
综合这些项目来看,下一项有价值的比较,应从同一片山地入手:使用相同的影像、明确的计数规则、经独立审核的轮廓,以及重复开展的测量。这样的比较有助于检验新模型究竟发现了先前遗漏的地貌、画出了更准确的边界,还是节省了专家的时间。不断扩充的编目让这项检验有了条件,也为研究人员标出了更多值得细看的地方。
来源
- 中国科学院青藏高原研究所,《青藏高原岩石冰川编目发布》(2026 年 8 月 24 日,中文机构报道)——TPRGI 的方法、总数、形变测量覆盖率,以及嘉黎县无人机照片。
- Zhangyu Sun 及其同事,《TPRoGI:利用深度学习建立的青藏高原综合岩石冰川编目》,Earth System Science Data(2024 年 12 月 17 日)——覆盖范围、制图规则与验证。
- Shijun Wang 及其同事,《东喜马拉雅岩石冰川编目更新》,Scientific Data(2026 年 6 月 27 日)——模型预测、人工修订,以及相互关联的单元与系统图层。
- Xin Guo 及其同事,《青藏高原东南部岩石冰川:基于深度学习与高分辨率影像的大范围编目》,Scientific Data(2026 年 8 月 5 日)——作者所属机构香港中文大学的研究记录与摘要。
- Mengzhen Li 及其同事,《青藏高原 Guokalariju 地区岩石冰川及其储水量评估》,The Cryosphere(2024 年 1 月 2 日)——厚度模型、含冰量假设与储量估算的不确定性。