机器人学习盘子该放在哪里时,有时也会顺带学到桌面的偶然特征。RoboTwin 让研究人员能够改变双臂操作任务的周围环境,检验学到的行为能否在变化后继续奏效。[1]
项目由上海交通大学与香港大学的团队联合牵头,合作方包括上海人工智能实验室。它为具身智能提供训练基础设施,服务于借助实体机器采取行动的智能系统。[1]
本文讨论的实验结果以 RoboTwin 2.0 论文的 2025 年 8 月 27 日修订版和 2025 年 6 月的挑战赛报告为准。软件此后仍在更新:代码仓库记载,2026 年 8 月 3 日新增了基于 XPolicyLab 的评测功能。[2][4][6]
给训练环境增加难度
RoboTwin 2.0 将示范生成系统与一个包含 147 个类别、731 件物体的资源库结合起来。多模态语言模型先提出任务代码,再根据仿真器执行后的反馈逐步修改。整套框架覆盖 50 项任务和五种机器人配置,并对杂物、光照、背景、桌面高度和语言指令引入变化。[1]
它的吸引力在于让机器人反复练习,同时有计划地改变条件。研究人员可以观察,周围环境变化后,学到的动作是否仍然有效,再据此决定还要补充哪类训练。相较于观看机器人在熟悉的桌面上又一次成功完成演示,这样的测试能给出更多信息。
同一基准,两组相差悬殊的平均值
论文的标准仿真基准使用 Aloha-AgileX 机器人配置,每项任务采用 50 条干净场景示范和 100 次测试运行,比较干净的“Easy”场景与随机化的“Hard”场景。在 50 项任务上,DP3 的平均成功率从 55.2% 降至 5.0%,Pi0 从 46.4% 降至 16.3%。DP3 在干净场景中的领先,也得益于理想的仿真点云和背景分割处理。[2]
另一项实机实验在 COBOT-Magic 平台上使用 RDT,测试四项任务。在十条真实示范之外加入 1,000 条随机化合成轨迹后,机器人在此前未见、带有杂物的背景下,平均成功率从 9% 升至 42%。约 367% 的相对增幅属于这一特定测试配置;按绝对差值计算,是从较低基线提高了 33 个百分点。[2]
这两项实验回答的是不同的问题。前者衡量机器人对仿真环境变化的敏感程度,后者检验合成数据练习能否帮助机器人在特定实体平台上完成任务。两者的结果都有各自的适用范围,尚不足以给出通用的机器人可靠性评级。
配置也是实验结论的一部分
官方配置指南列明了可供核查的环境选项。random_background 改变桌面和背景纹理,cluttered_table 加入会干扰任务的物体。桌面高度变化与头部相机位移各有独立控制项。公布的示例改变了桌面高度,同时将头部相机位移设为零。因此,即使实验标为“随机化”,仍要逐项确认实际启用了哪些变化。[3]
同一份指南也列出了学习系统所能看到的信息:普通彩色图像、深度、点云和分割数据是不同的选项。指南还允许利用已知的坐标变换,裁掉桌面和墙面的点云。[3] 模型作出第一次预测之前,这些选择就已经界定了它要解决的问题。
若要让分数之间的比较有意义,每项分数都应附上对应配置。采用更干净的输入可以是合理的实验选择;当这种选择贡献了部分成绩时,读者需要知情。
竞赛成绩还有一层适用限制
2025 年挑战赛的第二轮仿真比赛要求同一套策略在随机化条件下处理六项任务。实机决赛则采用了另外五项任务,包括倒水和叠布。每项实机任务先配发 300 条初始示范,随后再补充 20 条来自目标环境的示范。评测时,每项任务测试 20 次,其中 15 次使用熟悉的环境,五次使用此前未见的背景。实机赛道最高总分为 26.4 分,满分 100 分。[4]
这是一项竞赛得分。由于任务和评测规程都已改变,它无法用来测算相对于仿真轮次的百分比降幅。挑战赛展示了在这套规则下,实机操作依然具有很高难度。至于同一策略执行同一任务时,从仿真转向现实究竟带来多大影响,这场比赛的设计未能将其单独分离出来。[4]
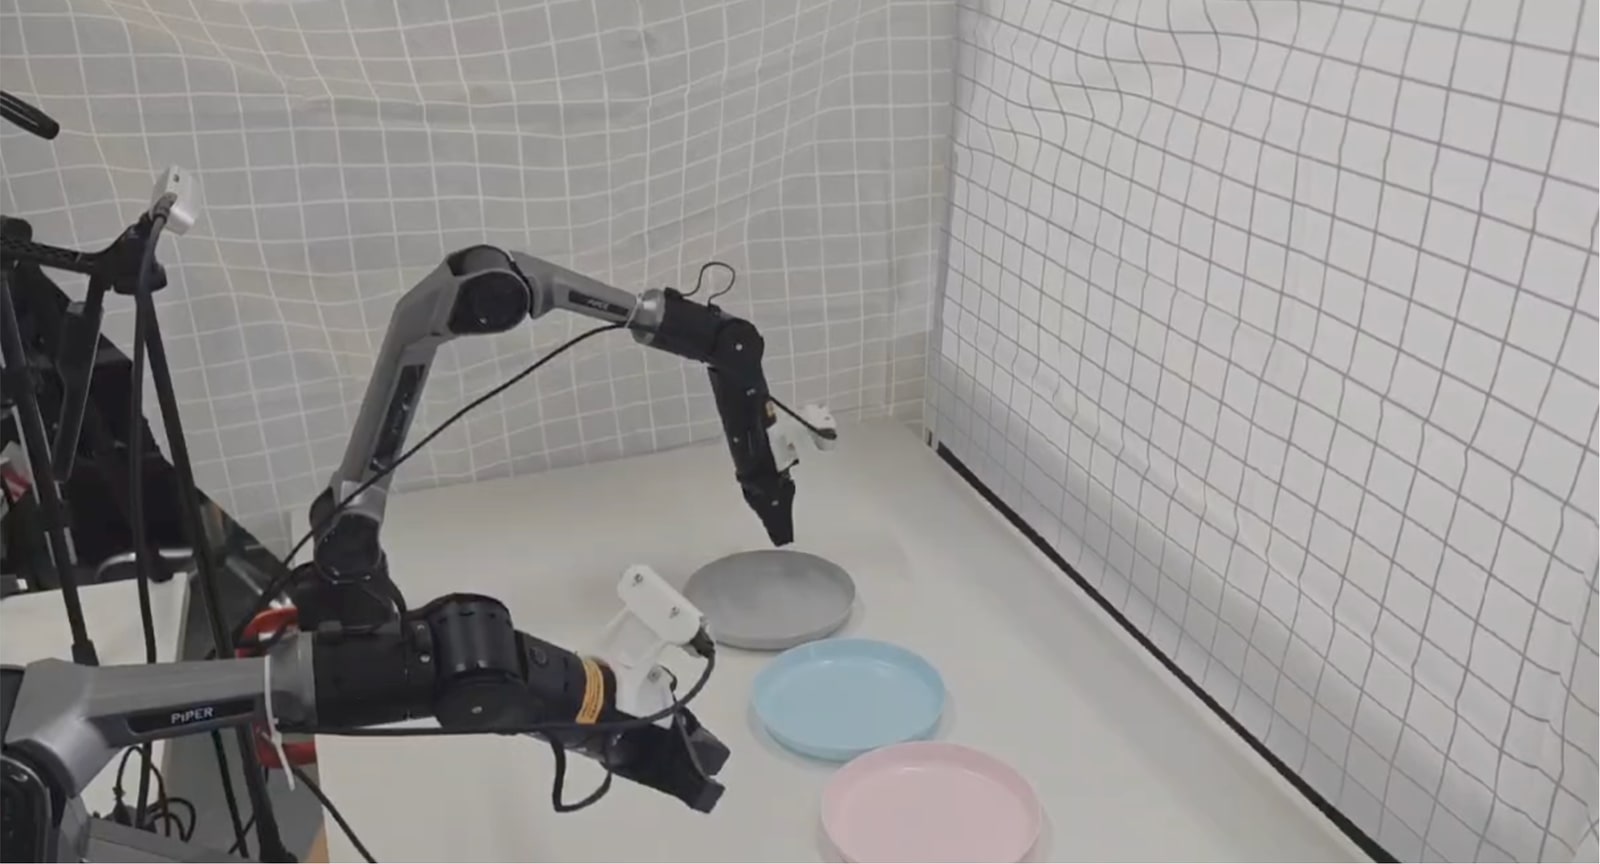
MIAA Lab 的中文参赛记录让实机任务有了更具体的面貌。其 6 月 19 日报告介绍了如何调整 RDT 和 Pi0 模型以适应实机任务,也收录了本文使用的叠盘子照片。[5] 照片记录了硬件与实际任务环境。单张静态图像能证明的范围有限,结果能否重复仍待试验检验;它也提醒读者,分数最终要描述的是夹爪、接触,以及一个必须落在正确位置的物体。
让评测工具本身也接受审视
RoboTwin 的代码仓库记载,2025 年 7 月 19 日修正了 DP3 评测代码,随后在 8 月 25 日修复 ACT 部署代码并更新排行榜。较新的 XPolicyLab 集成加入了单任务评测、多 GPU 调度,以及将远程策略服务器与本地仿真器分开运行的安排。[6]
这些更新会实质影响实验的运行方式。要让结果可以复现,就应一并保留代码修订版本、模型检查点、任务配置和评测规程。仅凭基准名称,仍缺少重建测试所需的信息。
从这些实验与工具来看,RoboTwin 的长远价值在于让实验中的选择清晰可见。合成数据训练可以带来有用的变化,实机试验则能检验这些变化到了实际操作中是否有效。报告同时保留结果及其产生条件,进展才更容易得到准确衡量。
来源
- RoboTwin 团队,“RoboTwin 2.0”——项目参与机构、物体库、示范生成与覆盖范围。
- Tianxing Chen 等,“RoboTwin 2.0”,arXiv v2,2025 年 8 月 27 日——第 4.4–4.5 节与表 4–5。
- RoboTwin 团队,“Configurations”——环境、相机与观测配置;访问日期:2026 年 9 月 15 日。
- Tianxing Chen 等,“Benchmarking Generalizable Bimanual Manipulation”,2025 年 6 月——挑战赛规程与实机赛道成绩。
- MIAA Lab,RoboTwin 真机挑战赛中文报道,2025 年 6 月 19 日——参赛记录与叠盘子照片。
- RoboTwin 团队,官方代码仓库——附日期的评测修正记录与 XPolicyLab 集成;访问日期:2026 年 9 月 15 日。