暴雨的位置报得大致准确,预报也未必保得住那些决定实用价值的细节。一条狭窄的强降雨带,与一大片中等强度降雨,带来的影响各有不同。2023 年 7 月推出的 NowcastNet,试图保留这一区别。它最引人注目的成绩来自人的判断:在一项有 62 名中国气象预报员参与的评估中,它在 71% 的案例里排名第一。[1]
这个数字值得细读。它描述的是专家在多份预报之间的偏好。了解这些偏好如何收集,再看另一支研究团队尝试适配模型时遇到了什么,NowcastNet 就成为观察中国科学 AI 发展的一个有启发的案例。
让降雨演变遵循物理规律
清华大学的中文公告将其与中央气象台、国家气象信息中心的合作追溯至 2017 年。到 2023 年 7 月,校方报告称,NowcastNet 已部署于全国 SWAN 3.0 临近预报平台。[1] 这份机构公告记录了当时的部署情况;本文讨论已发表的研究,现行服务的实际运行情况超出了本文的核查范围。
模型将两类工作结合起来。演变网络借助一个基于连续性方程的算子,学习降水的移动及其强度变化。生成网络随后以这一演变场为条件,生成更精细的细节。清华大学从物理过程的角度描述了这种分工:较大尺度的运动,以及较小尺度的对流发展。[1]
生成方法在这里的用法颇有意味,因为视觉上合理只是起点。设想一份预报画出了形态逼真的风暴单体,位置却与最终降下暴雨的地方隔着几座城镇。即使纹理十分出色,其实际指导价值仍会很低。因此,这项科学任务需要两方面的证据:预报呈现出怎样的形态,以及它与实际天气之间有怎样的关系。
读懂专家投票
发表于《Nature》的研究使用美国 2016–2020 年的雷达观测训练模型,并以 2021 年的数据测试。在中国部分,研究者用 2019 年 9 月至 2021 年 3 月的观测,微调已在美国数据上预训练的模型,再用 2021 年 4–6 月的数据评估。[2]
专家评估时,各模型的预报隐去名称、打乱顺序后呈现。62 名气象预报员每人评判 15 个从极端降水子集中随机抽取的案例。其中一项评估展示了后续实况观测,供专家对照预报与结果。另一项评估隐去这些实况,要求专家依据此前的雷达序列作出判断。参与比较的方法包括 pySTEPS、DGMR 和 PredRNN。[2]
两项评估的差别直接影响结果的含义。看到实况时,预报员可以依据事实检验一份预报;实况尚不可知时,预报员是在不确定条件下选择预报参考。若两项评估得出一致的偏好,当然有研究价值,但两者回答的问题各有侧重。将它们合并成“明天的预警有多大把握报对”这一说法,会超出评估本身所能回答的范围。
论文还用临界成功指数(critical success index)的邻域版本评估降雨位置的预报水平,用功率谱密度评估空间变异性。[2] 这些指标与人的排序并列,为评估补充了另一种视角。
71% 这一醒目结果反映的是专家偏好,与某次具体预报正确的概率属于不同指标。 在一轮比较中胜出,表示它比该轮提供的其他方案更受青睐。某个城镇的强降雨会以多大频率到来、预计有多少次空报、预警能否及时送达人们手中,这些问题都超出了偏好排序本身的解释范围,需要各自的观测记录和统计分母。
观测数据中已有工程处理
美国部分的输入来自多雷达多传感器系统(Multi-Radar Multi-Sensor,MRMS)。[2] 美国国家海洋和大气管理局(NOAA)将 MRMS 描述为一个自动化系统:它把雷达数据流与其他观测、模式信息整合起来,生成气象产品,处理工作包括拼图、质量控制和降水估算。[3]
把这类材料统称为“雷达数据”,容易让神经网络上游的处理选择隐入背景。拼图要把各处观测拼接成可用的数据场,质量控制则帮助判断哪些测量值值得信任。学习系统接手的,已经是一幅经过处理的大气图景。
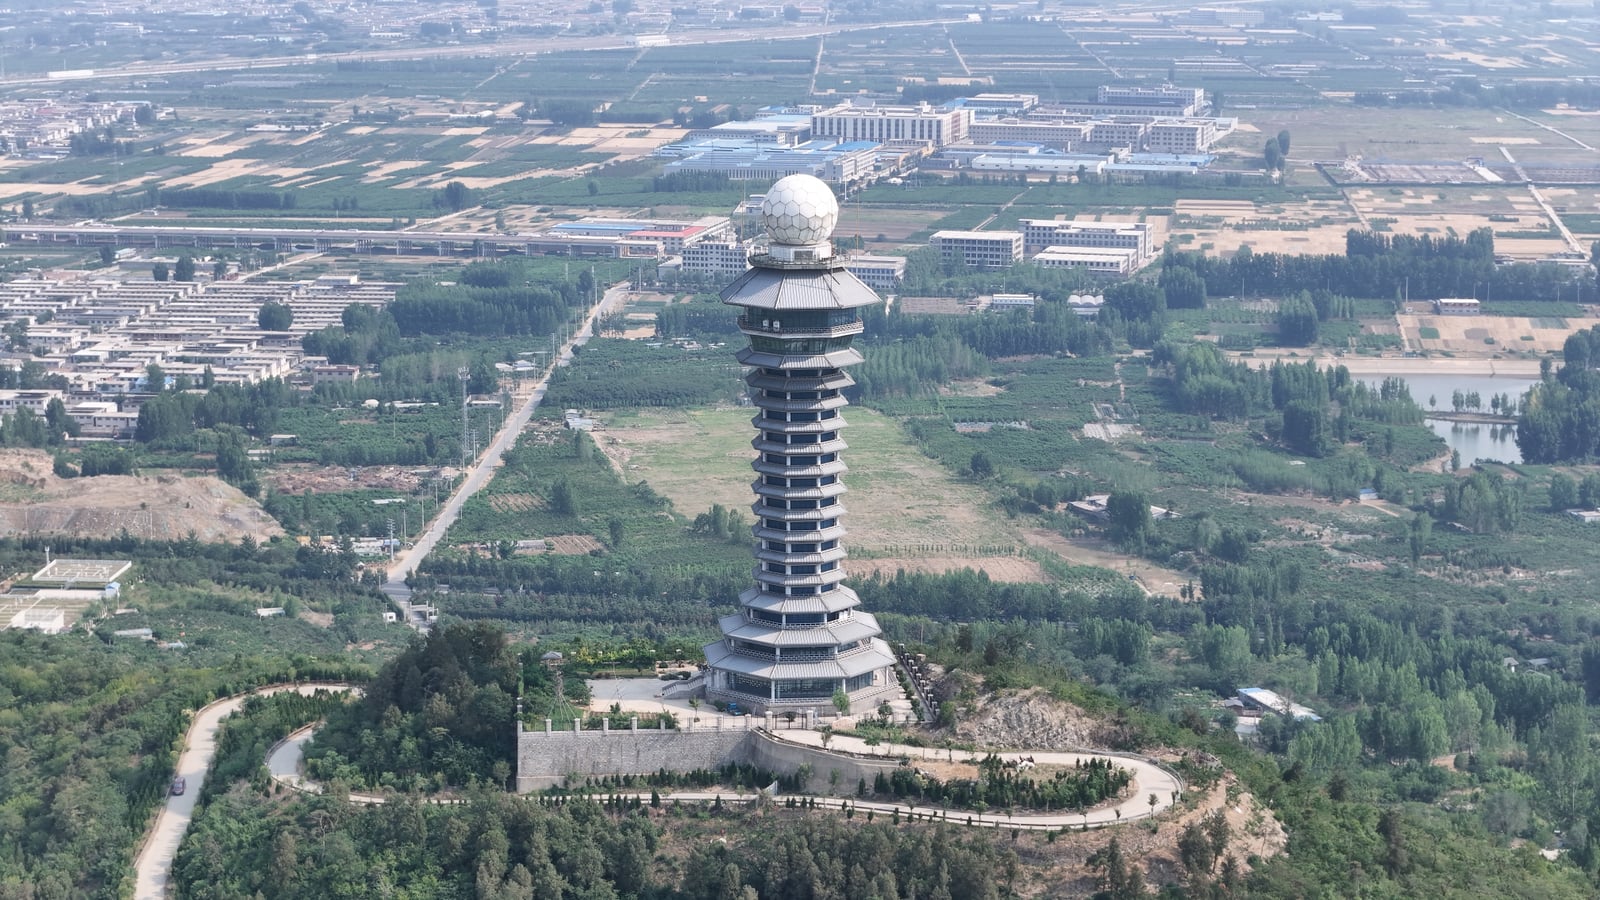
照片中的临沂茶芽山雷达塔,让这项工作所依托的实体设施进入视野。[5] 照片用于展示观测设施,这座塔是否为研究提供过数据,本文未作认定。建筑、仪器和周围的地貌都与这个故事相关,因为气象 AI 的起点,是在某个具体地点完成的测量。
加拿大带来另一场检验
加拿大环境与气候变化部及 IBM Research 的研究者在一篇 2025 年的会议论文中,考察了模型的本地适配。他们报告称,推理代码和预训练权重可以获取,原始训练代码和完整数据集则未公开。研究者自行实现了训练流程,并尝试用加拿大雷达拼图进行微调。[4]
数据准备包括将观测重采样至 10 分钟的时间间隔和 2 公里的空间间距。2023 年 6 月用于验证,2023 年 7–8 月用于测试。为减轻边界效应,研究在较大的输入裁剪区域内部划出一块区域,用于检验预报。在这一设置下,微调版本在论文报告的评分上未能优于原始模型。[4]
对于微调未见提升,作者提出了一种有待验证的解释:预训练生成器需要与一个从头训练的判别器配合。研究者还因未能完成演变网络的微调,将其保持冻结。这些都是本次适配尝试的局限。图中另有一项比较细节:原始版本的评分每隔 30 分钟计算一次,微调版本则每隔 10 分钟计算一次。[4]
这项结果的价值,也在于它给后续问题留出了空间。它表明,加入本地观测并追加训练,本身尚不足以保证改进;更好的适配流程仍有探索余地。发布可用于预测的系统、给出重新训练所需的方法,以及拿出足以信任重训版本的证据,分别代表不同的研究贡献。
接下来值得关注什么
在本文看来,NowcastNet 的持久贡献还包括它所采用的评估安排:邀请一线预报员评判,隐去模型身份,区分已知实况后的判断与未知实况时的判断,同时保留数值检验。
更有说服力的后续研究,可以把这些做法延伸到另一个季节或另一套雷达网络,按预报时效和降雨阈值分别报告结果,并同时衡量漏报与空报。届时,下一条引人注目的成绩就会有清楚的含义。值得延续的成果,是测试条件改变后,优势依然清晰可见的预报。
来源
- 清华大学软件学院,NowcastNet 发布公告,2023 年 7 月 7 日(中文);关于合作、模型架构、专家评估及所报告部署情况的一手介绍。
- Yuchen Zhang 等,《Skilful nowcasting of extreme precipitation with NowcastNet》,Nature 619,526–532,2023 年 7 月 5 日;训练与测试数据划分、气象预报员评估流程、比较方法及定量评估。
- NOAA 国家强风暴实验室,《Multi-Radar/Multi-Sensor System (MRMS)》;观测处理系统的官方说明,核查于 2026 年 9 月 25 日。
- Dominique Brunet、Daniel Salles Civitarese 与 Didier Davignon,《An Improved Implementation of NowcastNet with Fine-Tuning for Canada》,第 41 届国际雷达气象学大会,2025 年;扩展摘要第 3–5 节及图 4。
- WPTO,临沂茶芽山气象雷达观测塔照片,2024 年 6 月 10 日;Wikimedia Commons,CC BY 4.0。