截至 2026-05-26 UTC,若只把阿里巴巴 MNN 看成 AI 中国版图中一个不起眼的开源运行时,便会漏掉更醒目的变化:MNN 正在成为阿里巴巴连接开放模型发布与设备端运行的一座桥。公开仓库称其为轻量级框架,已用于 30 多个阿里巴巴应用 和 70 多种业务用途;建立其上的 MNN-LLM,则负责在手机、PC 和 IoT 设备上本地部署大语言模型。[1] 托管式 Qwen 端点出售云服务,MNN 开辟的是另一条分发渠道,服务于模型贴近用户、传感器或企业终端运行的需求。
中国模型竞争一直同时跑在两条线上。最醒目的一条是前沿模型的发布节奏:Qwen、DeepSeek、Hunyuan、ERNIE、GLM、Kimi、MiniMax 等模型不断刷新基准测试与产品界面。另一条较少进入公众视野,关乎模型如何打包和运行。一套模型若无法在手机、笔记本电脑、嵌入式盒子及混合加速器后端上达到可用性能,开放权重发布就更接近理论承诺,难以成为工程现实。MNN 回答的是后一个问题。排行榜每周换谁领先固然醒目,工程团队还要解决另一件事:怎样把模型做成离开云控制平面也能运行的软件包。[1][2][3]
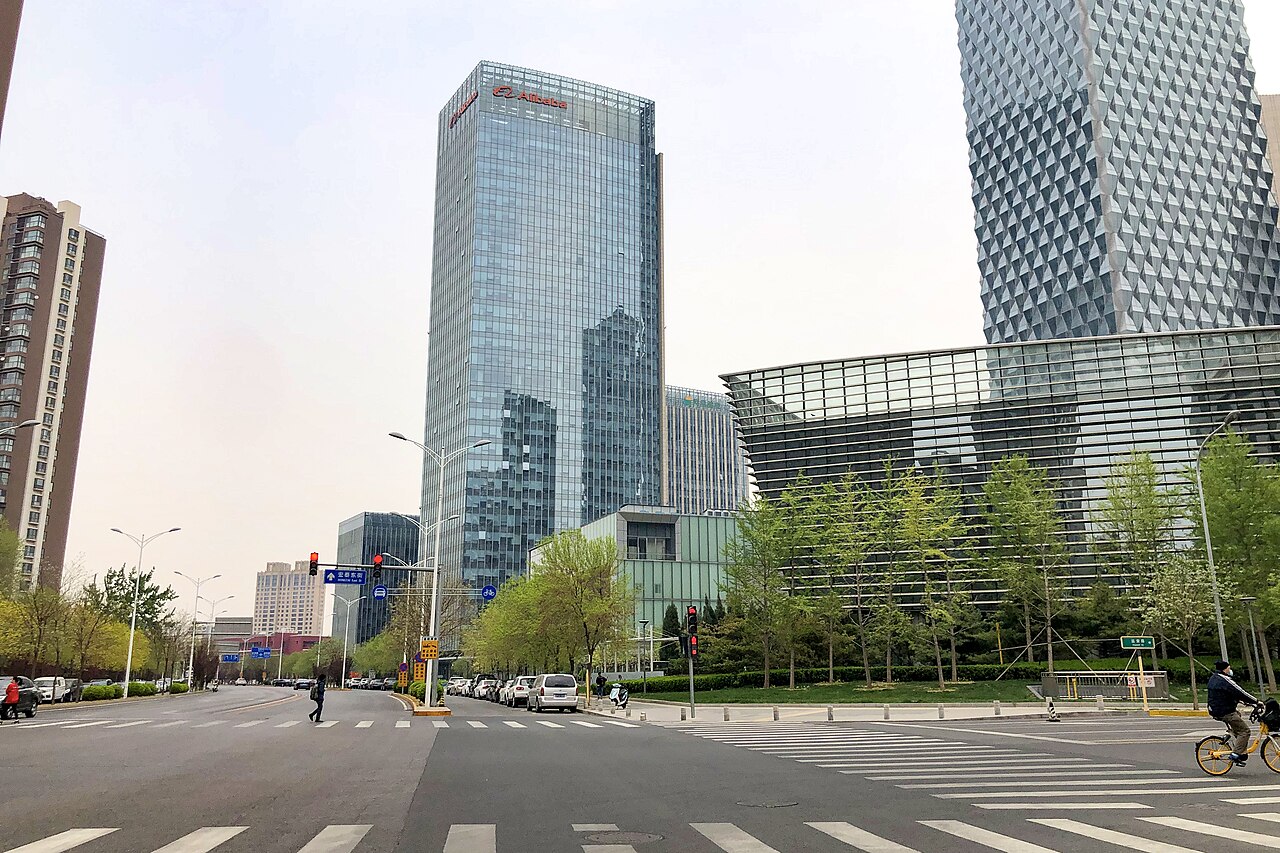
图片背景:封面照片来自 Wikimedia Commons,画面中的阿里巴巴北京总部位于望京绿地中心。机构建筑的视角取代了示意图,也提示了一种读法:MNN 是阿里巴巴的一组基础设施。运行时、应用外壳、后端层、模型导出路径与生产历史组合在一起,使其模型能够脱离托管 API,移植到更多设备。[7]
设备端通道已经有了具体产品
MNN README 对项目的定位,已经从传统的移动神经网络推理向外拓宽。仓库称 MNN 支持设备端推理与训练,并列出淘宝、天猫、优酷、钉钉、闲鱼等阿里巴巴应用;嵌入式设备与 IoT 也在其用途之列。[1] 这些生产记录很关键:MNN 在阿里内部已有长期部署经历,手机上的研究演示只占其公开面貌的一部分。
到了 LLM 这一层,转向更加清楚。同一仓库将 MNN-LLM 定义为基于 MNN 的运行时,用于在手机、PC 和 IoT 设备上本地部署 LLM,并支持 Qianwen/Qwen、Baichuan、Zhipu、LLaMA 等模型家族。[1] 官方更新日志依次记录了产品范围的扩展:2025 年 2 月推出 iOS 多模态 LLM 应用,2025 年 4 月加入 Android 端 Qwen3 支持,2025 年 5 月支持 Qwen2.5-Omni,2026 年 3 月又支持 Qwen3.5 系列。[1]
关键就在这条连续的更新线上。MNN 持续跟进中国及全球开放模型的发布节奏,将它们引入边缘运行时通道,关注范围早已越过某一个模型权重版本。对阿里巴巴而言,这条通道有两项战略用途。一方面,当延迟、隐私、断续网络或云成本构成限制时,Qwen 相关应用可以转向本地运行。另一方面,MNN 同样支持非阿里巴巴模型,对希望兼容多个模型家族的开发者也更有用。[1][4]
发布说明写出了工程重心
最近的发布说明比项目口号更能说明问题。MNN 3.4.0 发布于 2026 年 2 月,主要改进包括 GPU/QNN 后端适配、注意力计算与长上下文内存优化,以及线上 GPU 的稳定性。[2] 具体清单逐项对准边缘 LLM 运行时的实际难题:让更多 Android 设备支持 Vulkan LLM、加入 Vulkan CoopMat 加速、Metal TensorAPI 和 Flash Attention、CPU Flash Attention、CPU KV-cache 量化、Prefix KV Cache、Qwen3 与视觉语言模型的 QNN 支持、OmniQuant 导出,以及 llmexport 的混合精度量化。[2]
随后发布的 3.4.1 沿同一方向继续推进。它聚焦 Qwen3.5 支持,以及覆盖 CPU、Metal、OpenCL、Vulkan 后端的 Linear Attention;同时修正 LLM 实例的资源管理,并处理 Shape 算子、执行算子、HQQ 量化、大词表 embedding、LLM 路径和 GPU 后端的安全与稳定性问题。[2] 这类改动直接决定本地推理能否跨过演示阶段:内存是否够用,后端覆盖是否完整,资源能否正常释放,还要应对崩溃、算子缺口、量化表现与模型导出故障。
单纯列出模型的资料,很少触及这些问题。下载一个 checkpoint 只是开头;同一应用还得穿过不同芯片、图形 API、操作系统策略、内存上限、tokenizer 细节、模型格式与功耗预算,并且保持正常运行。MNN 的发布说明记录的正是工程团队如何一点点拓宽稳定运行的范围。[2][3]
应用外壳把能力与限制一并摆到眼前
MNN Chat Android README 展示了阿里巴巴怎样把运行时装进用户和开发者可以直接使用的应用。它描述了一款完整的多模态 LLM Android 应用,支持文本到文本、图像到文本、音频到文本,以及借助扩散模型生成文本到图像。[3] 兼容名单也很长,覆盖 Qwen、Gemma、Llama、TinyLlama、MobileLLM、Baichuan、Yi、DeepSeek、InternLM、Phi、ReaderLM 和 SmolLM。[3]
这些性能数字要连同测试来源一起读。README 称,MNN-LLM 在 Android CPU 上推理 Qwen-7B 时,预填充(prefill)速度比 llama.cpp 快 8.6x、比 fastllm 快 20.5x,解码速度则分别快 2.3x 和 8.9x。[3] MNN-LLM 论文给出了方向相近的结果:模型量化、DRAM-Flash 混合存储、适配移动 CPU/GPU 的重排、多核负载均衡、混合精度与几何计算协同工作,相比主流 LLM 专用推理系统,最高带来 8.6x 的速度提升。[5] 这些结果来自厂商或论文作者,证据范围止于自报结果,跨设备的独立横向测试仍然缺席。现有材料可以支持一项范围更窄的判断:MNN 当前公开工作的重心,已经转向移动 LLM 推理的具体瓶颈,泛化的神经网络加速则退到次要位置。[3][5]
README 中的警告与速度数字同样重要。文档称,该应用版本仅在 OnePlus 13 和 Xiaomi 14 Ultra 上测试;低配或入门设备存在推理缓慢、不稳定或无法运行的风险。[3] 这条警告也划定了本文论点的范围:现有证据不足以说明每部手机都已适合运行本地前沿模型。它所显示的是,阿里巴巴正持续投入运行时工程,逐步扩大可用硬件的范围。
Hugging Face 模型包接通了分发环节
Hugging Face 上的 taobao-mnn 组织展示了这条通道的另一端:除了运行时源码,这里还有为 MNN 打包的模型文件。查阅时,该组织列出 24 个合集(collection),包括 MNN 版本的 Gemma、LFM、MiniCPM、DeepSeek-R1-Qwen、Qwen2.5-Coder 和 Qwen3.6 变体;多项条目在 2026 年 4 月和 5 月更新。[4] 具体条目还会变化,持续把模型打包给 MNN 使用的做法,比任何单个模型权重版本更值得关注。
这些模型包透露了阿里巴巴对 MNN 的期待:让它从模型开发完成后才会用到的构建目标,逐步成为一种易于识别的分发格式。运行时、Android/iOS 应用、导出工具和托管模型文件一旦彼此衔接,开发者的准备工作就会缩短。团队可以直接评估模型是否适合放到设备端,省去从头设计转换与部署流程的工作。[1][2][3][4]
这一点对 AI 中国尤其关键。人们评判开放权重发布时,常看模型能否从 GitHub、Hugging Face、ModelScope 或云模型工作室获取。MNN 让评估多了一问:这个模型在工程上能否直接用于本地运行?较小的 Qwen、DeepSeek 蒸馏模型、MiniCPM 或代码模型,若以移动应用或边缘设备可以加载、跑分并更新的形态交付,其价值也会随之改变。[4]
更早的 Walle 经历显示 MNN 扎根于生产系统
MNN 的生产沿革也比许多边缘 AI 项目更深。MNN README 将它与阿里巴巴的 Walle 系统联系起来;OSDI 2022 论文把 Walle 描述为一个端到端、通用且大规模的设备—云协同机器学习生产系统。[1][6] 论文摘要称,Walle 的核心借助 MNN 的算子分解和半自动搜索等方法,减少大量算子与硬件后端所需的人工优化;其数据和部署流水线还支持设备端流处理及多粒度部署策略。[6]
端侧 LLM 同时受模型体量和部署系统制约,所以这段历史很关键。AI 工作从云端点移到用户设备后,平台必须处理推送/拉取部署、后端选择、本地计算、可观测性、版本管理与故障恢复。Walle 的材料不足以证明 MNN-LLM 已经解决现代生成式模型的全部问题;它至少表明,阿里巴巴早在当前 LLM 浪潮之前就已积累设备—云协同能力。[6]
由这段沿革推断,MNN 当前的 LLM 方向延续了阿里巴巴一项长期判断,范围也超过孤立的开源实验:一部分智能应在数据与交互发生之处运行;云端负责协调、分发,并在需要时接手更重的任务。[1][6]
观察重点
首先要看的是,阿里巴巴发布自家较小的 Qwen 模型和多模态模型时,MNN 究竟会成为默认首发目标,还是停留在发布后的转换通道。若 Qwen 新版本经常同步带来 MNN 模型包、Android/iOS 应用支持、llmexport 配方、后端说明、量化指导与设备限制提示,MNN 就会进入阿里巴巴的模型分发约定。[1][2][3][4]
第二项要看后端覆盖。近期最有分量的证据来自 Vulkan、Metal、OpenCL、QNN、Flash Attention、KV-cache 量化、Prefix KV Cache 和模型导出工作,CPU 速度数字只是其中一部分。[2] 若这些工作持续紧跟模型发布周期,端侧推理便会逐渐离开实验室,成为能够持续维护的产品通道。
反证条件同样明确。如果开发者仍只把 MNN 当作漂亮的演示,在正式部署中继续首选云 API、浏览器 agent 或其他本地运行时,“设备通道”这一判断就会失去说服力。模型打包若跟不上 Qwen 的发布,稳定运行的机型若长期局限在很窄的范围,或性能数字始终无法在少数旗舰手机之外复现,这项判断也会受到削弱。
眼下,MNN 值得持续跟踪,因为它显示 AI 中国的供应链正向模型层下方延伸。模型、价格表与云 API 仍在竞争,战线还扩展到模型家族通往可部署本地软件包的整条道路:运行时、后端、量化、应用外壳、模型包和生产更新历史。MNN 清楚表达了阿里巴巴的一项主张:设备端仍在这套技术栈之内。[1][2][3][4][6]
来源
- Alibaba,
alibaba/MNNGitHub 仓库 README(MNN 项目范围、30 多个阿里巴巴应用、70 多种用途、MNN-LLM 的使命、支持的模型家族,以及截至 Qwen3.5 支持的更新记录)。 - Alibaba,
alibaba/MNNGitHub 发布页面(MNN 3.4.0 与 3.4.1 发布说明,涵盖 Vulkan、Metal、QNN、Flash Attention、KV-cache、Qwen3/Qwen3.5、llmexport、资源管理和稳定性修复)。 - Alibaba,“MNN Chat Android App” README(多模态 Android 应用功能、支持的模型家族、Android 构建标志、厂商报告的 Qwen-7B CPU 基准数据和设备支持警告)。
- Hugging Face,
taobao-mnn组织页面(MNN 模型合集,以及近期更新的 Qwen、DeepSeek、MiniCPM、Gemma 等 MNN 模型文件)。 - Wang 等人,“MNN-LLM: A Generic Inference Engine for Fast Large Language Model Deployment on Mobile Devices”(arXiv:2506.10443;移动端 LLM 推理设计、量化、DRAM-Flash 混合存储、适配 CPU/GPU 的优化和论文报告的加速范围)。
- Lv 等人,“Walle: An End-to-End, General-Purpose, and Large-Scale Production System for Device-Cloud Collaborative Machine Learning”(arXiv:2205.14833;OSDI 2022 论文,讨论 MNN 的生产沿革、算子分解、后端搜索、设备端流处理和部署策略)。
- Wikimedia Commons,N509FZ 拍摄的“File:Alibaba Group Beijing headquarters at Greenland Center, Wangjing (20210410104117).jpg”(本文所用 2021 年实景照片的来源页面)。