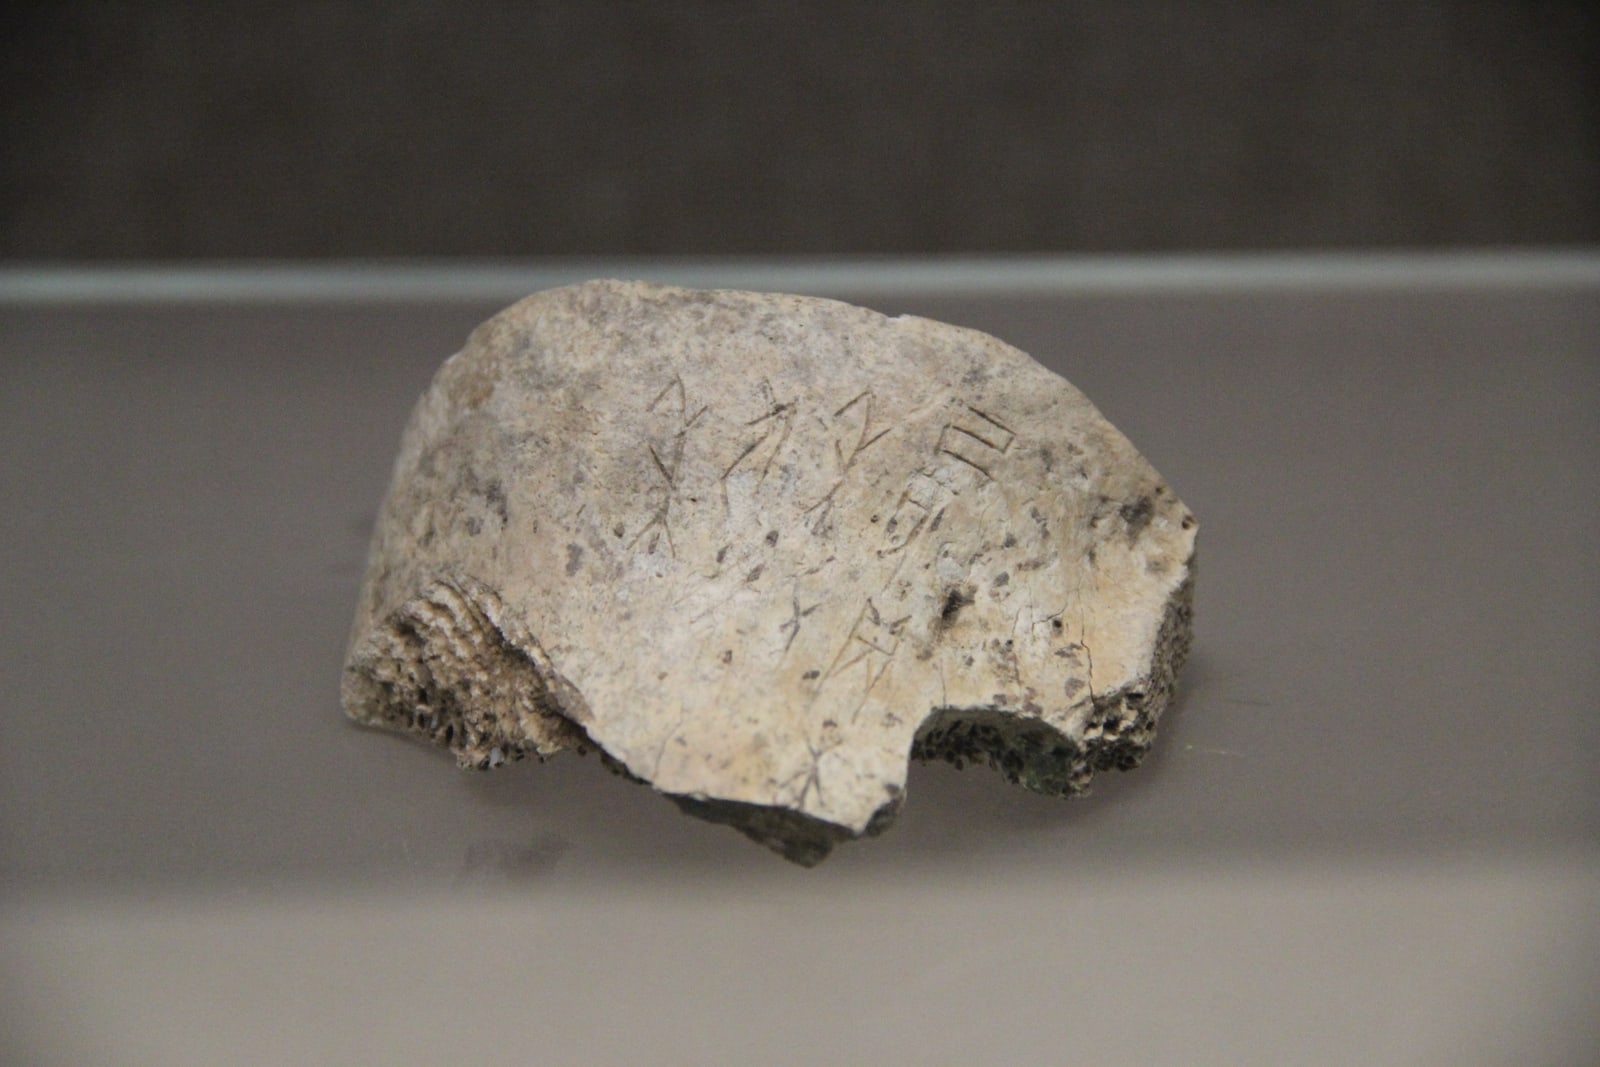
一块刻着文字的牛骨,同时摆出两道难题:哪些痕迹是文字,这些文字连在一起又说了什么。裂纹截断笔画,看着眼熟的字也有多种形体。即使已经辨认出每个字,读者仍要从中还原关于人物、行为和情境的一份记录。[4]
S-OBI 把第二道难题变成了一项 AI 测试。 它要考查的是,模型能否将古老的字形连成一则完整卜辞,读出其中的含义与结构。公开版本要求模型完成释义、阅读顺序判断、语义角色识别、断句和缺字补全。相比给裁切出的单字图像贴上标签,这向前跨出了一大步。[2]
项目研究人员分别来自南京理工大学、上海交通大学和上海人工智能实验室。他们于 2026 年 6 月 30 日发布的预印本报告了一组悬殊的成绩:Qwen3.6-Plus-thinking 的字序选择得分为 89.2%,含义匹配得分为 32.6%。选出合理的顺序,显然比还原刻辞所说的内容更容易。[1]
字迹更清楚,问题更深入
此前获 ICLR 2025 接收的 OBI-Bench 汇集了 5,523 张图像,涵盖识别、残片缀合、分类、检索和释读五类任务,材料包括甲骨实物、拓片和单字。它覆盖的范围较广,意在考查多模态模型能在学者的研究流程中帮助完成哪些工作。[3]
S-OBI 将考查范围收窄到完整的一组卜辞。作者用更清楚的字形范例替换受损字形,同时保留原刻辞的内容和组织方式。这一处理减少了部分视觉噪声,也让实验所用的材料与出土实物的表面拉开了距离。[1]
中英文发布文档记载,数据包含 95 则基础卜辞和 695 道题目。这两组数字的统计口径不同:题目和图像变体反复取材于同一小批卜辞。数据包同时收录原始拓片图像和制作后的基准测试图像,计分任务使用的是经过整理的输入。[2]
三类任务分别检验不同方面的理解。T1 询问含义和顺序。T2 要求按字段填写一份记录,列出主体、行为、对象、时间和结果,以及交代占卜背景的前辞信息与待占问的命题。T3 则要求在已排定顺序的字格中断句,或根据上下文补出缺失的字。[2]
对于读者,这种区分很直观。把句子的各个部分排成熟悉的顺序,仍有把行为安到错误人物身上的风险。文辞流畅的解释,恰好能遮住这样的错误。基准测试将各个部分拆开提问,让流畅的回答有了逐项核对的依据。
已公布的分数能说明什么
预印本评测了十个模型,其中部分经由 API 调用,本地运行的模型最多使用八张显存为 24 GB 的 RTX 4090 GPU,各模型均采用默认生成设置。表中 Qwen3.6-Plus-thinking 的总体得分为 33.5%。作者还报告,所有受测模型中,整组槽位(字段)完全正确的记录数均为零。这些成绩仅反映论文设定的实验条件,既未给出 2026 年 11 月的排行榜,也未衡量模型解读博物馆馆藏材料的成功率。[1]
值得关注的是各项能力的落差。一个系统即使能帮助排列候选读法,在填写整份记录时仍会暴露出可靠性问题。对于研究助手,这是两种不同的工作。前者可交出一份供人审阅的结果;后者则需要足够的准确性,才能作为论述某次古代事件的依据。
评分方法决定如何理解分数
公开工具包将“有所进展”和“完整答对”之间的区别落到了具体算法上。T2 的主评分对若干分项指标取平均值,其中一些要求完全匹配,另一些则按列表内容的重合程度或字符序列的相似度给分。另有一项独立指标,专门记录所有槽位是否全部精确匹配。[2]
设想一份回答填对了主体和日期,却填错了行为。分项评分可以给正确的部分计分,同时保留整份记录出错的判断。这种做法有助于诊断模型在哪些地方取得了进展;若把所得百分比当成已完整读懂的卜辞占比,就会误读成绩。
汇总方式也会影响结果。T2 有 350 道题,T1 和 T3 分别为 190 道和 155 道。若对所有题目直接取平均值,槽位提取任务就占有更大的权重。工具包推荐的总体指标则让三类任务各占相同权重。两种口径各有用途,回答的是关于模型表现的不同问题。[2]
维护者明确提醒,要复现论文表格,运行已发布的评分程序之外,还须匹配模型输出和评测条件。截至 2026 年 11 月 6 日核查时,发布版本也尚未划定官方训练集、验证集或测试集。沿用自上游数据集的标签,与这样的官方划分应当分清。[2]
由此可以确立一条实用的比较准则:数据包版本、提示词、模型修订版本和评分协议应当一并记录,汇总成绩旁也应列出各项结果。由于不同变体共用基础卜辞,今后若用其中一部分材料训练模型,还应说明如何将相互关联的卜辞分隔开。否则,在同组熟悉样例上的好成绩,就有被误认成对未见刻辞的迁移能力的风险。
回到甲骨实物
2026 年的一篇甲骨文计算研究综述,列出了标准化输入所减轻的材料难题:甲骨破碎、字形多变、形近字易混淆,以及拓片损伤。综述也指出,材料以拓片为主的数据集,难以充分满足系统处理甲骨实物的需要。[4]
S-OBI 的价值,正在于从这些更广泛的困难中单独抽出一个问题。如果模型面对字迹更清楚、组织更规整的刻辞仍然吃力,缺少的理解能力就超出了改进相机所能补足的范围。同样,在这些整理后的图像上取得进步,仍须放到学者实际接触的材料表面上检验。
下一项有说服力的成果,应当将两方面的检验连在一起:先更准确地还原完整的语义记录,再拿出证据,证明改进在原始照片和陌生卜辞上依然成立。在此之前,S-OBI 给出了一种有用的追问方式,帮助查清解读错在何处,也让已经理解的部分始终清晰可见。
来源
- Ziqi Li、Zijian Chen、Tingzhu Chen、Guangtao Zhai,《Beyond Single Character: Evaluating MLLMs for Sentence-Level Oracle Bone Inscription Understanding》,2026 年 6 月 30 日预印本,第 1 版;数据构造、实验设置与报告结果。
- OBI-Future,S-OBI 官方仓库;中英文发布文档、v1.0.0 数据集模式与评测协议,核查于 2026 年 11 月 6 日。
- OBI-Future,OBI-Bench 官方仓库;ICLR 2025 接收情况、图像清单与五类研究任务。
- Zijian Chen 等,《Oracle bone inscriptions information processing: a comprehensive survey》,npj Heritage Science,2026 年 4 月 8 日;材料难题与数据集局限。
- Gary Todd,《Ancient Chinese Writing on Ox Bone, Shang Dynasty》,2011 年 12 月 13 日摄于安阳中国文字博物馆;图像记录与 CC0 声明。