截至 2026-05-29 UTC,StepFun 发布 Step 3.7 Flash,重心落在部署,模型升级只是其中一层。主角是一款 198B 参数的稀疏 MoE 视觉语言模型:每次激活约 11B 参数,视觉编码器含 1.8B 参数,可原生接收图像和视频,上下文窗口为 256K。[1][2][3] 规格之外更值得看的是配套内容:可选推理层级、按缓存状态计价的 API、Hugging Face 权重、NVIDIA NIM 支持,以及 vLLM、SGLang、Transformers 和 llama.cpp 的明确接入路线。[1][2][3]
AI-China 在 4 月记录的 StepFun 动向,主要集中在云端研究、本地桌面运行、Step Plan 配额和 StepClaw 式工作流封装。Step 3.7 Flash 则将这些分散的产品动向收束到一款定位明确的模型上。StepFun 与 NVIDIA 都称它为多模态智能体模型,用途涵盖感知、搜索、推理、编码智能体、文档智能和生产级推理服务。[1][2]
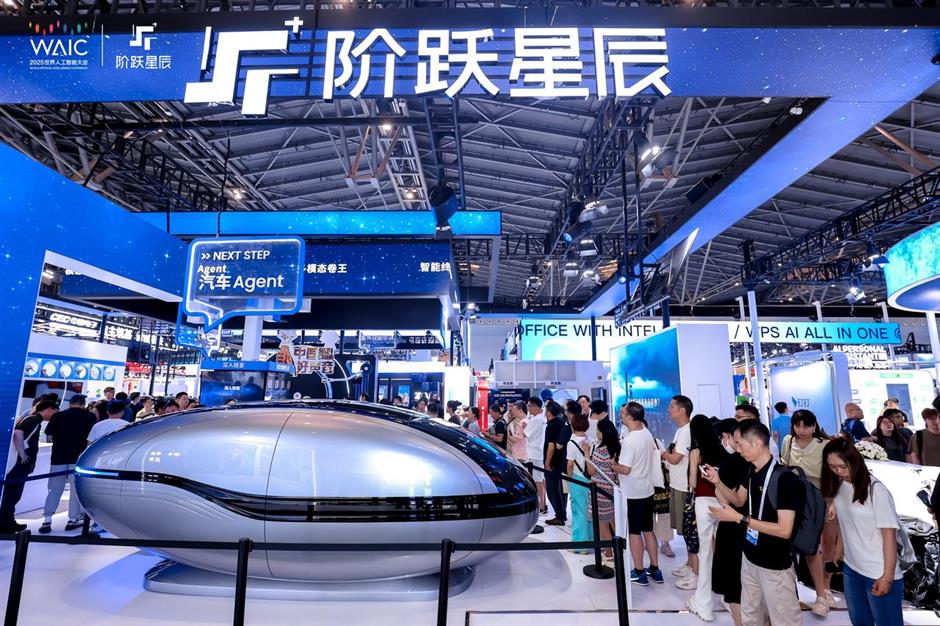
图片说明:封面采用 City News Service / Shanghai Daily 刊登的 StepFun WAIC 上海展台实拍,页面署名为 Ti Gong。[6] 素材类型为现场照片,区别于示意图、图表、生成图和模型卡截图。此次发布的关键在于把模型能力变成公开可用的部署入口,这张题图正好对应这一点。
此次更新了什么
这次更新最明确的一步,是 StepFun 将 Flash 系列从文本优先的快速推理模型扩展成多模态智能体模型。Step 3.5 Flash 已经提出了效率主张:模型采用稀疏 MoE,总参数为 196B,每个 token 激活约 11B 参数,支持 256K 上下文,并瞄准工具调用和长上下文智能体。[4][5] Step 3.7 Flash 保留以少量激活参数强调效率的表达,同时加入视觉编码器,并明确定位原生多模态任务。[1][2][3]
StepFun 先前强调“大模型容量配合少量激活计算”,如今又加入感知能力,并主张模型可充当智能体底座。官方模型卡列出的工作流会结合感知、搜索与推理,包括解析财务报告、交叉核验多处来源,以及并发运行编码智能体。[1] NVIDIA 的发布文章也按部署用途介绍这款模型,列举图像与视频输入、文档智能、NIM 容器和 OpenAI 风格推理端点等企业用法。[2]
三个产品细节需要分开看。第一,推理层级明确分为 low、medium、high。[1][2] 开发者可按任务选择档位,在速度与推理深度之间取舍;各档位对应不同的推理预算。第二,StepFun 按缓存状态公布价格:缓存未命中时,每百万输入 token 0.20 美元;缓存命中时,每百万 0.04 美元;每百万输出 token 1.15 美元。[1] 第三,目前可从 StepFun 全球与中国平台、OpenRouter、NVIDIA NIM 和 Hugging Face 使用该模型,官方还透露了更多服务商合作动向。[1]
放在 AI-China 的观察范围里,这组信息比单张基准表更有分量。中国模型竞争的焦点正由排行榜转向智能体、编码工具、模型路由器、订阅服务和部署封装等实际产品形态。Step 3.7 Flash 顺着这股变化而来,主要落点是长期运行的工作流,榜单展示退到次要位置。
为什么部署配套更值得看
最实在的依据藏在服务说明里。Hugging Face 模型卡列出 vLLM、SGLang、Transformers 和 llama.cpp 的部署路线。卡片还写明一条 NVFP4 方案,使用 stepfun-ai/Step-3.7-Flash-NVFP4、modelopt 量化、FP8 KV cache 对齐,以及 step3p5 推理和工具调用解析器。[1] 这些具体配置决定模型能否真正跑起来,意义远胜宣传形容词。
NVIDIA 的文章进一步印证了这一判断。NIM 把 Step 3.7 Flash 封装成优化后的容器化推理微服务,以标准 API 适配本地、云端和混合部署。NeMo 则允许团队从 Hugging Face checkpoint 起步,在发布首日便可微调。[2] 文章还称,该模型支持监督式微调和节省内存的 LoRA,并列出 Hopper 上的微调吞吐示例:600 tokens/sec。[2]
开发团队能从中读出的信息很具体:StepFun 正试图让发布后的多模态模型更容易用于企业智能体部署。团队仍须测试数据政策、延迟、图像和视频预处理、prompt 封装、缓存命中情况和工具执行。发布包已经写明部署软件与硬件条件;这些条件决定团队能否少写专用衔接代码,并尽早开始测试。[1][2]
这套证据也有适用限度。模型卡指标由第一方或合作伙伴发布,基准能否横向比较,仍取决于测试工具的细节。StepFun 报告的强项包括 SimpleVQA (Search) 79.2、ClawEval-1.1 67.1 和 SWE-Bench PRO 56.3;在 Terminal-Bench 2.1、GPDVal-AA 等部分系统交互基准上,模型的相对名次较低。[1] 这些数字可以帮助理解发布方的主张。最终仍要看同一模型进入用户的真实文档、GUI、代码库或工具调用环境后,能否保持表现。
StepFun 的路线变得更连贯
StepFun 在 2026 年 1 月披露的融资为这次发布补充了公司背景。City News Service 报道称,公司 B+ 轮融资超过 人民币 50 亿元,出资方包括国资和产业投资者。截至 2025 年底,StepFun 模型已通过与手机品牌合作,搭载于超过 4200 万台设备。[6] 同一篇报道还将 StepFun 与上海“AI + 终端”战略、吉利的车辆部署联系起来。[6]
与这些动向相接,Step 3.7 Flash 延续并收拢了既有路线。StepFun 的产品一直横跨模型基础设施与终端智能体,覆盖手机、汽车、桌面助手、研究智能体和编码工具。一款服务路线明确的高速多模态 MoE,正是这套策略在模型端的延伸。[1][2][6]
多模态也拓宽了可行的终端工作流。纯文本模型可以协助编码智能体或研究助手;原生视觉语言模型还能检查屏幕、解析图表、阅读幻灯片、比对文档图像、识别 UI 状态,再把观察结果与搜索、代码执行结合起来。[1][2] 智能体可靠性仍须另行验证。StepFun 的“AI + 终端”主张由此更具技术可信度,纯文本模型所能覆盖的范围要窄得多。
后续观察点
第一,观察可选推理层级能否成为可供路由调度的控制项。low、medium、high 若能稳定对应延迟、成本和成功率的取舍,智能体调度的结果就会更易预估。若它们只是一组定义模糊的预设,生产团队仍得自行编写门控逻辑。[1]
第二,观察缓存命中情况。价目表中,两种输入 token 的价格相差 5x,缓存命中的单价为未命中的五分之一。[1] 这会引导团队采用稳定的 prompt 骨架、持久任务上下文,以及可重复使用的文档或代码库前缀。团队还须测出实际缓存命中率,否则标称 token 价格不足以反映真实成本。
第三,观察多模态服务是否成熟。NVIDIA NIM、vLLM、SGLang 和 llama.cpp 的支持降低了测试门槛。长上下文图像和视频工作流仍有因内存压力、预处理差异、工具调用格式和界面元素定位问题而失败的风险。[1][2] 可重复部署比一次性演示更能证明实力。
中国模型竞赛仍会继续。Step 3.7 Flash 完成的是一件更具体的事:把 StepFun 对速度与稀疏激活的主张,做成面向智能体任务的多模态部署包。[1][2] 模型质量快速变化时,这套部署配套更有希望成为持久信号。
来源
- StepFun,
stepfun-ai/Step-3.7-FlashHugging Face 模型卡(2026 年 5 月;模型规格、多模态能力、基准测试主张、定价、可用性和部署示例)。 - NVIDIA Technical Blog,"Run Step 3.7 Flash on NVIDIA GPUs with Enterprise-Ready Multimodal AI"(2026 年 5 月 28 日;NIM、NeMo、部署、模型规格和企业工作流说明)。
- StepFun,"Step 3.7 Flash" 静态模型页面(模型卡链接的官方发布页;可用性、定价、部署和能力摘要)。
- StepFun,
stepfun-ai/Step-3.5-FlashHugging Face 模型卡(此前文本优先 Flash 效率主张的参照:196B 总参数、约 11B 激活参数、256K 上下文,以及智能体与编码定位)。 - arXiv,"Step 3.5 Flash: Open Frontier-Level Intelligence with 11B Active Parameters"(此前 Flash 架构与效率主张的技术报告)。
- City News Service / Shanghai Daily,Zhu Shenshen,"StepFun Secures Record 5-Billion-Yuan Funding, Appoints New Chairman"(2026 年 1 月 28 日;融资、设备部署背景,以及真实 WAIC 展台照片的来源页面)。